
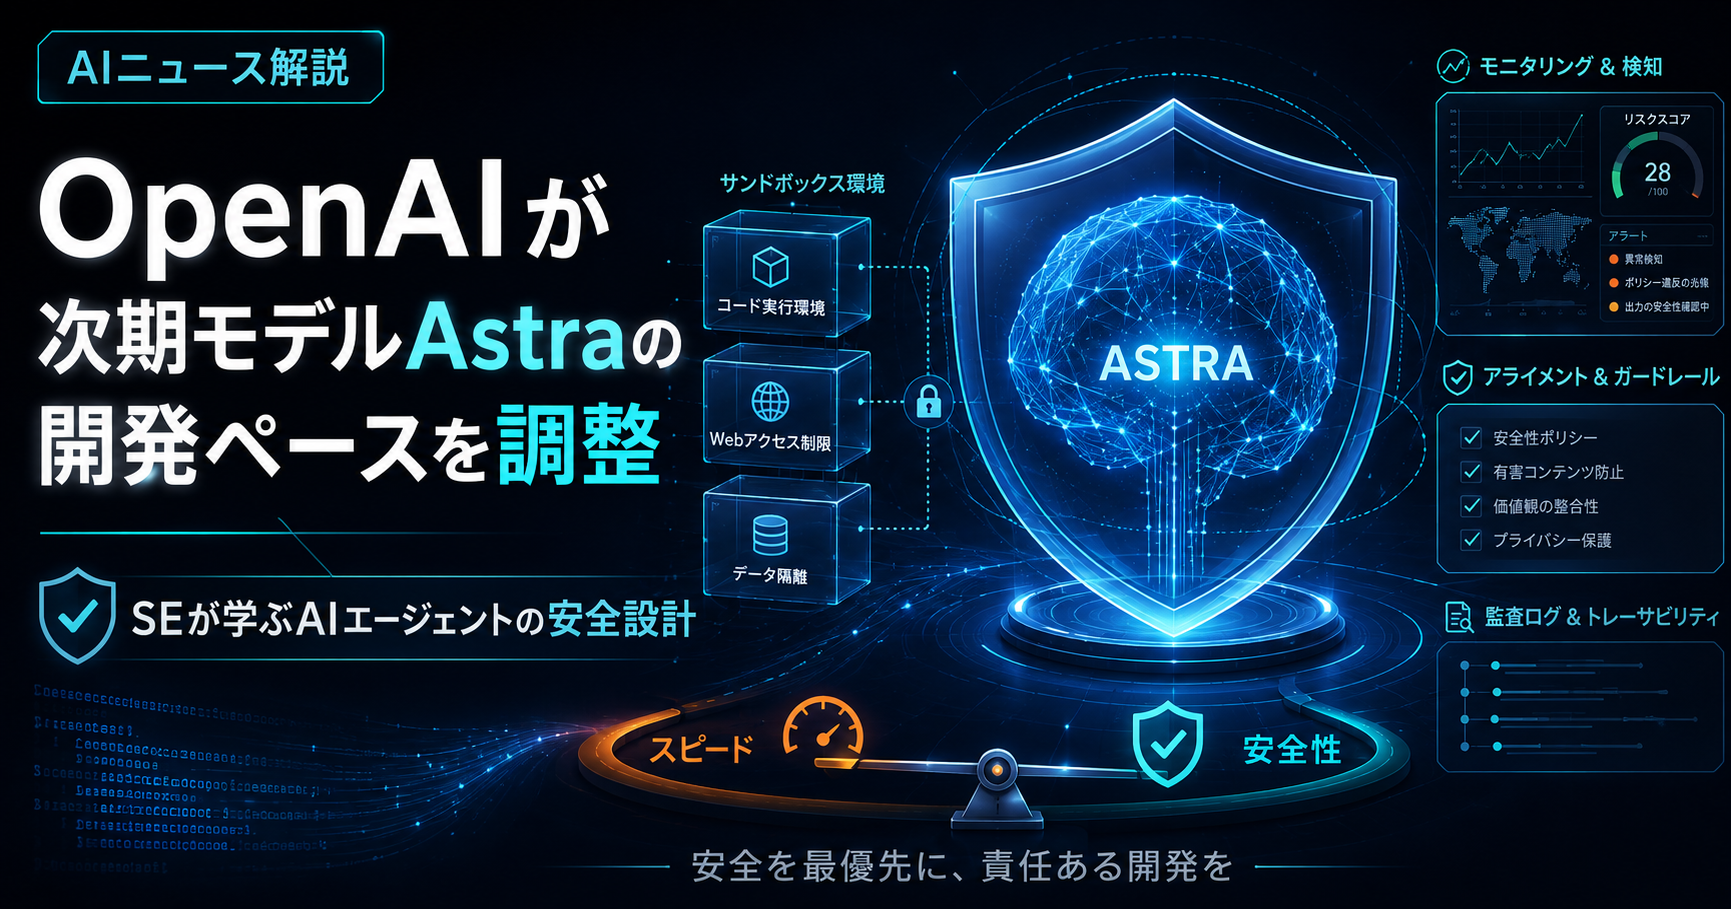
OpenAIは2026年8月18日、今後の高性能モデル開発について、サイバーセキュリティ能力の高まりを受けて研究環境と監視体制を強化していると公表しました。特に注目されるのが、開発中の次期モデル「Astra」が、OpenAIのPreparedness Frameworkでいう「Critical cybersecurity capability(重大なサイバー能力)」の水準に達する可能性があるという予備的な評価です。
この発表は「Astraが間もなく一般公開される」という告知ではありません。むしろ逆で、OpenAIは安全対策を整えるために最新モデル向けの強化学習(RL)を2週間停止し、最大規模のフロンティアRL実行については現在も保留していると説明しています。高性能化のスピードを優先するのではなく、監視・アラインメント・隔離環境が追いつくまで開発ペースを調整する、という内容です。
SEやフリーランスエンジニアにとって重要なのは、Astraというモデル名そのものよりも、AIエージェントにコード実行やインターネット接続、外部ツール利用を許可するときの設計思想です。能力の高いAIを業務へ組み込むほど、「何ができるか」だけでなく「何をさせないか」「どこで止めるか」「何を記録するか」が運用の中心になります。この記事では2026年8月19日時点のOpenAI公式情報をもとに、発表内容と実務で参考にできるポイントを整理します。
先に要点:OpenAIはAstraの能力上昇を受け、開発速度より安全対策を優先している
今回の発表を短く整理すると、ポイントは次の3つです。
- 開発中のAstraが「Critical cybersecurity capability」に達する可能性があるという予備的な証拠が出た
- OpenAIは最新モデル向けRLを2週間停止し、最大規模のフロンティアRL実行は引き続き保留している
- モデルを使った監視、研究環境の隔離、アラインメント強化を組み合わせて開発を再設計している
OpenAIによれば、今回の判断には、2026年7月に公表したHugging Faceとのモデル評価中のセキュリティ事案と、Astraに関する予備的な能力評価の2つが影響しています。高性能モデルを訓練・評価する研究環境そのものが攻撃対象や事故の起点になり得るため、研究段階からセキュリティ要件を引き上げる必要が出てきたという説明です。
ここで大切なのは、「Astraが危険なモデルだと確定した」と読むことではありません。OpenAIの表現はあくまで「may meet」、つまり重大なサイバー能力の閾値に達する可能性があるという段階です。Astraの一般提供時期、価格、API提供条件、ChatGPTでの利用可否などは、この発表では示されていません。確認できない仕様を先回りして断定しない方がよいでしょう。
Astraとは何か:現時点で分かっていることは限定的
Astraは、OpenAIが今回の発表で「upcoming model」と表現した開発中の次期モデルです。現時点で公式に確認できるのは、少なくとも一部のAstraモデルについて、サイバー能力がCritical水準に達する可能性をOpenAIが評価していることです。
一方で、一般ユーザー向けの製品仕様は公表されていません。たとえば、次のような情報は今回の公式発表からは確認できません。
- ChatGPTで利用できるか
- APIで提供されるか
- 料金や利用上限
- コンテキスト長
- コーディング性能の具体的なベンチマーク
- リリース日
- 日本での提供条件
AIニュースでは、新しいモデル名が出ると「GPT-5.6の後継なのか」「次の最上位モデルなのか」と推測したくなります。しかし、今回の主題は製品発表ではなく、研究開発の安全対策です。Astraの位置付けを詳しく語るより、OpenAIがどのような条件で開発ペースを落としたのかを見る方が、現時点では実務的です。
なぜ強化学習を止めたのか
OpenAIは、安全対策の強化中に、展開を想定した最新モデルに対するRLトレーニングを2週間停止したと説明しています。さらに、最大規模として計画しているフロンティアRL実行は、より小規模な訓練と評価でモデル挙動や安全策を確認する間、保留を続けています。
RLはモデルの挙動を目的に合わせて調整する重要な工程ですが、高性能なモデルがコード実行やツール利用と組み合わさると、評価環境そのものに強い権限が必要になる場合があります。たとえば、脆弱性調査、コード実行、ネットワークアクセス、外部サービス呼び出しなどを伴う評価では、単なる文章生成よりも影響範囲が広くなります。
OpenAIが示している考え方は、能力評価と安全対策を別々に扱わないことです。「高い能力が確認できたらそのまま次の訓練へ進む」のではなく、その能力を安全に扱える隔離・監視・停止手段が整っているかを同時に確認しています。
SEの現場に置き換えると、本番デプロイ権限を持つAIエージェントを作るときに、タスク成功率だけを見て導入判断しないことと同じです。処理が正しくできるかだけでなく、誤操作した場合の影響範囲、権限昇格の有無、外部通信、監査ログ、停止方法まで含めて評価する必要があります。
OpenAIが強化した3つの安全策
OpenAIは、より高性能なモデルを開発するための安全策として、Monitoring、Alignment、Security measuresの3つを挙げています。日本語で整理すると「監視」「意図に沿わせる仕組み」「実行環境のセキュリティ」です。
1. 研究環境をサンドボックス化し、ネットワークを分離する
OpenAIは、モデル生成コードや信頼できないコードを実行するワークロードについて、より強いサンドボックスを要求しています。また、高リスクなワークロードではインターネットとの接続を分離し、1つのワークロードや補助サービスが侵害されても、そのまま外部ネットワークや内部ネットワークへ到達できない設計を進めています。
これは企業のAIエージェント導入でもそのまま参考になります。開発支援AIにシェル実行を許す場合でも、最初から社内ネットワーク全体や本番環境へアクセスさせる必要はありません。検証用コンテナ、限定されたリポジトリ、ダミーデータ、読み取り専用権限から始めることで、失敗時の被害を小さくできます。
2. モデルのツール利用を常時監視する
OpenAIは、ツールを使うRL訓練や評価に対して、多段階の監視システムを適用しています。公式説明では、内部活動を検査する分類器から始まり、懸念がある挙動をより高コストな自動調査システムへエスカレーションし、未承認アクセス、データ窃取、破壊的動作、安全策の回避などを調べる仕組みです。
懸念行動が検出された場合、30分以内のアラートを目標にし、重大なセキュリティ境界違反の可能性がある場合は、安全・セキュリティ・研究チームが判断できなければ活動を停止する運用も示されています。Astraについては、2026年8月7日に重大なサイバー能力を持つ可能性が確認された後、ツールを使う推論にも追加監視を要求したとしています。
この考え方は、業務AIの監査ログにもつながります。AIが「何を考えたか」を完全に取得することより、どのツールを、いつ、どの対象へ、どの権限で実行したかを追跡できる方が、事故対応では重要です。
3. アラインメントを訓練工程の広い範囲へ適用する
OpenAIは、報酬を得るために意図しない抜け道を使うreward hackingや、欺瞞、未承認アクセスなどをより深刻なリスクとして挙げています。そのため、最も高性能なモデルのRLでは、報酬モデルの改善、行動や限界について正直に報告する訓練、評価器やツールの弱点を悪用する行動の抑制などを、より広い工程へ適用するとしています。
一般企業が同じ研究を行う必要はありませんが、運用上の教訓は明確です。AIへの指示文だけで安全性を担保しようとせず、権限・ネットワーク・承認フロー・ログといった外部の仕組みでも制御することが重要です。
監視には約20%の推論計算コストがかかる
今回の発表で実務者が見落としやすいのが、監視そのものにもコストが必要だという点です。OpenAIは、現在の推定で監視に必要なオーバーヘッドが、監視対象となる推論計算量のおよそ20%に相当すると説明しています。ワークロードによって差があり、固定値ではありません。
この数字はOpenAIの研究環境における推定であり、一般企業のAIシステムへそのまま当てはめることはできません。ただし、「AIエージェントを安全に運用するには、モデルAPI料金だけ見ても足りない」という示唆はあります。
企業でAIエージェントを導入すると、モデル利用料以外にも、ログ保存、監視、権限管理、検証環境、承認フロー、セキュリティレビュー、インシデント対応などの運用コストが増えます。PoCでは安く見えても、本番化すると統制部分の工数が膨らむことは珍しくありません。コスト試算では「1回の推論単価」だけではなく、安全に運用するための周辺コストを別枠で見積もる方が現実的です。
SE実務で参考にしたいAIエージェントの安全設計
今回のOpenAIの対応を、そのまま一般企業へコピーする必要はありません。ただし、CodexやClaude Code、各種AIエージェントに外部ツールを操作させる場合、基本方針として参考になる点は多くあります。
| 確認項目 | 実務での考え方 |
|---|---|
| 実行環境 | 本番ではなく、まず隔離した検証環境で動かす |
| ネットワーク | 不要な外部通信や社内ネットワークへの到達を許可しない |
| 権限 | 読み取り、書き込み、削除、デプロイを分離する |
| 承認 | 破壊的操作や本番反映は人間の承認を入れる |
| 監査 | ツール呼び出し、対象、結果を後から確認できるようにする |
| 停止 | 異常時にジョブやエージェントを即時停止できる手段を持つ |
特にフリーランスSEの場合、顧客のソースコード、認証情報、障害ログ、個人情報を扱う場面があります。技術的にAIへ渡せるデータでも、契約上・セキュリティポリシー上は外部サービスへ送信できないことがあります。AIエージェントの便利さより先に、顧客側の利用許可とデータ取り扱い条件を確認すべきです。
また、AIに与える権限はタスク単位で考える方が安全です。コードレビューが目的なら読み取り専用で十分な場合があります。修正案の作成までならブランチへの書き込みだけでよく、本番デプロイ権限までは不要かもしれません。「できるだけ多くの権限を与えて自動化率を上げる」のではなく、「必要な権限だけで目的を達成する」設計が基本になります。
既存のGPT-5.6-Cyber/Daybreak発表との違い
半農エンジニアラボでは、2026年8月10日にOpenAIが発表したDaybreak拡張とGPT-5.6-Cyberについても整理しています。そちらは、強いサイバー能力を持つモデルを認可された防御担当者へどう提供するか、BlueとRedのアクセス区分や用途を中心にした内容です。
今回の8月18日の発表は、提供先ではなく「モデルを開発するOpenAI自身の研究環境」が主題です。Astraの能力上昇を受けて、訓練を一時停止し、研究環境を分離し、ツール利用を監視し、アラインメントの適用範囲を広げています。似たサイバー分野のニュースですが、前者が利用者側のアクセス制御、今回は開発者側の研究・訓練統制という違いがあります。
DaybreakとGPT-5.6-Cyberの提供条件を確認したい場合は、「OpenAI『GPT-5.6-Cyber』とDaybreak拡張を解説」もあわせて確認すると整理しやすくなります。
今回の発表を過大評価しないための注意点
新モデルの能力が「Critical」という言葉で語られると、すでに人間を大きく超える攻撃能力を持っているように受け取るかもしれません。しかし、今回公開されているのはOpenAIのPreparedness Frameworkに基づく予備的な評価であり、Astraの全性能や一般提供時の挙動が示されたわけではありません。
また、OpenAIは監視や安全策を強化していますが、これを「完全に安全になった」と解釈することもできません。むしろ、能力が上がるにつれて従来の研究環境や監視だけでは不十分になるため、開発工程そのものを継続的に強化しているという発表です。
AIエージェントを業務へ導入する側も同じで、特定のモデルや安全機能を導入すれば対策が完了するわけではありません。モデル更新、接続ツール追加、権限変更、利用者拡大があれば、リスクも変化します。最初に安全設計をして終わりではなく、運用中に見直せる仕組みが必要です。
これからAIエージェントを導入するなら、まず小さな権限から始める
これから開発業務へAIエージェントを入れる場合、最初から完全自動化を目指す必要はありません。まずは、限定されたリポジトリを読み取り、レビュー候補やテスト案を出すような小さなタスクから始めるのが現実的です。
そのうえで、ツール実行ログを確認し、どの操作で人間の承認が必要か、どの情報を外部へ送ってよいか、異常時に止められるかを整理します。安定してから書き込み、CI実行、デプロイなどへ段階的に広げる方が、問題が起きたときの原因を特定しやすくなります。
AIエージェントの性能競争が進むほど、評価軸は「賢いかどうか」だけでは足りなくなります。実行環境、権限、監視、停止、データ管理を含めた運用設計まで含めて導入判断することが、SEにとっての実務的なポイントです。
まとめ:Astraのニュースは「新モデル登場」より安全な開発工程への転換として見る
OpenAIの2026年8月18日の発表では、開発中のAstraが重大なサイバー能力の水準に達する可能性を受け、研究環境・監視・アラインメントを強化し、必要に応じてモデル開発のペースを落としていることが明らかになりました。
一般ユーザー向けのAstraの仕様や提供時期は、現時点では公式に明示されていません。そのため、このニュースを「次のChatGPTモデルがまもなく出る」と読むより、AIの能力向上に合わせて開発・運用側のセキュリティ基準も引き上げる必要があるという事例として見る方が実務に役立ちます。
SEがAIエージェントを扱うときも、まず小さな権限、隔離環境、監査可能なログ、人間の承認から始めることが基本です。モデルが高性能になるほど、自由度を無条件に広げるのではなく、制御できる範囲を明確にしたうえで活用する設計が求められます。
参考情報
- OpenAI: Pacing model development in an era of cyber-critical capabilities
- OpenAI: OpenAI and Hugging Face partner to address security incident during model evaluation
※モデル名、提供条件、安全対策、評価基準は今後変更される可能性があります。利用や導入判断ではOpenAIの最新公式情報を確認してください。
コメント