
AIエージェントを業務システムへ組み込むと、単に「回答を生成するAI」ではなく、データベースを書き換える、返金処理を行う、コードを実行する、といった本番状態を変更する存在になります。ここまで進むと、従来のチャットボットと同じ感覚で「システムプロンプトに禁止事項を書けば安全」と考えるのは危険です。
Googleは2026年8月17日、Agent Development Kit(ADK)を使ったゼロトラストAIエージェントの構築例をGoogle Developers Blogで公開しました。中心となる考え方は、モデルを完全には信用せず、LLMの外側に強制力のあるセキュリティ境界を置くことです。
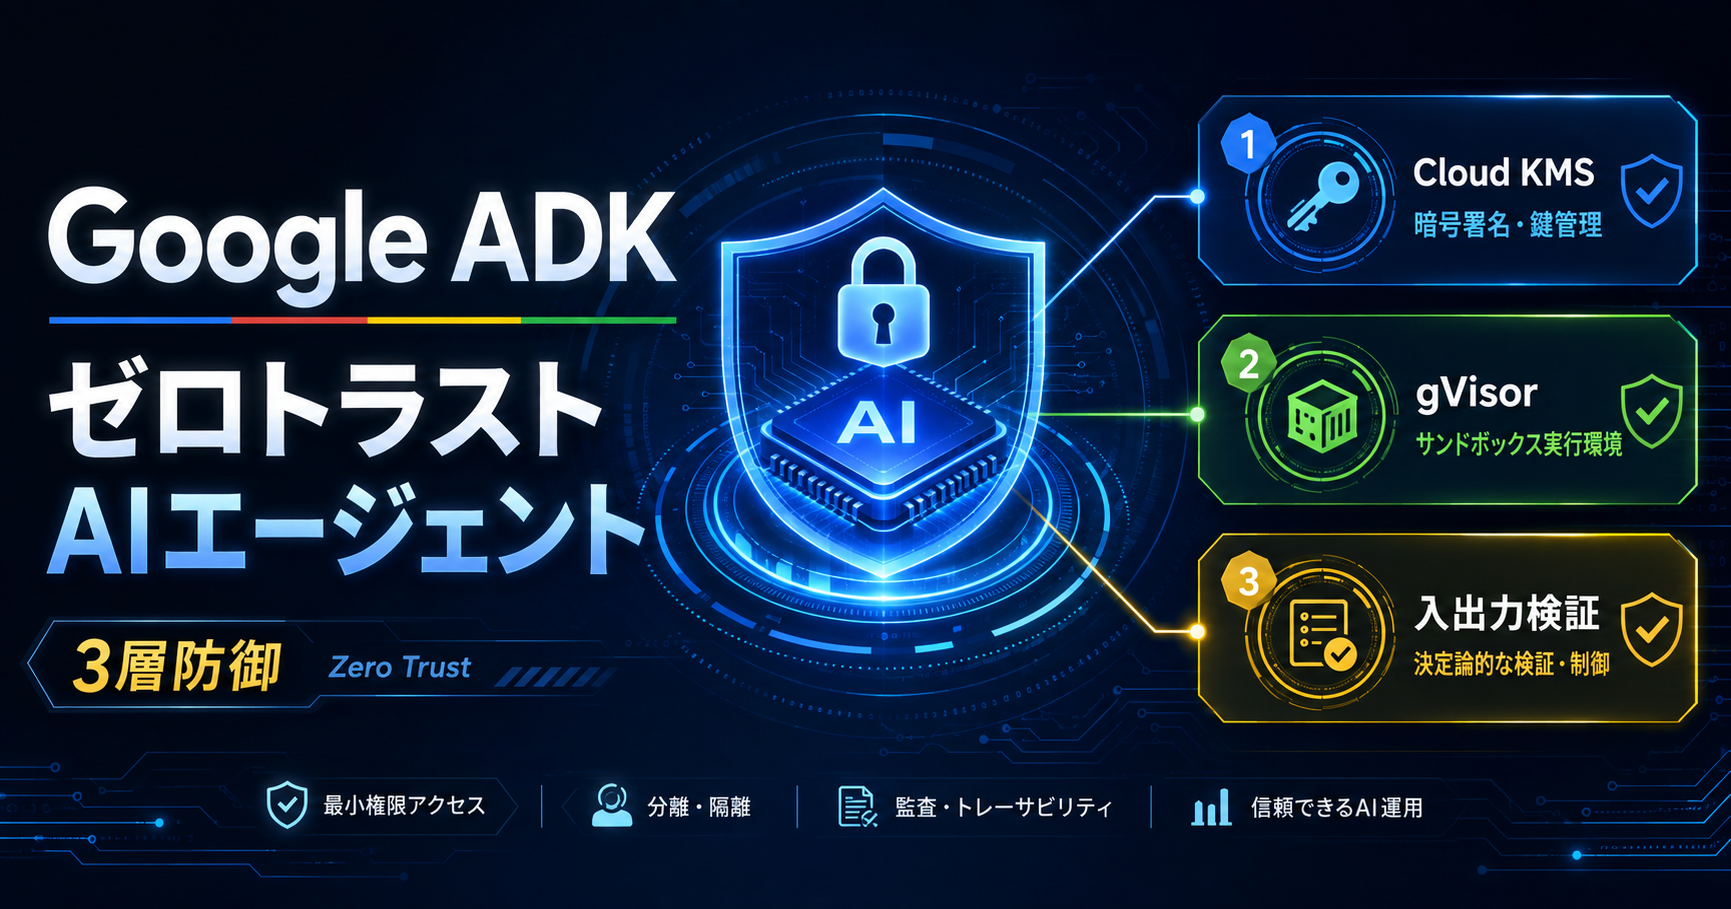
公式記事では、顧客サポートと返金処理を行う自律エージェントを例に、①データ更新への暗号署名、②gVisorによるコード実行の隔離、③決定論的な入出力ゲートウェイという3層の対策を示しています。
SEやフリーランスエンジニアにとって重要なのは、Google Cloudの特定サービスをそのまま採用することだけではありません。「AIが誤判断しても、権限やインフラ側で被害を止める」という設計思想を、自社のAIエージェントへどう取り込むかです。この記事では、2026年8月21日時点のGoogle公式情報を基に、3つの防御層と実務での使いどころを整理します。
先に要点:AIエージェントは「モデルを信用しない」前提で設計する
Googleのゼロトラスト構成を短くまとめると、次の3層です。
- 書き込み処理:エージェントごとの暗号鍵で署名し、誰が変更したか検証できるようにする
- コード実行:gVisorなどの隔離環境で実行し、ネットワークやCPU、メモリ、権限を制限する
- 入出力:LLMの前後に決定論的な検証を置き、禁止データや業務ルール違反を機械的に止める
ポイントは、これらをプロンプトの指示だけに依存させないことです。モデルが「返金上限を守る」と理解していても、プロンプトインジェクションや将来のモデル更新、ツール利用時の判断ミスによって想定外の操作が起こる可能性があります。
そのため、モデルは「考える役割」に寄せ、実際の変更権限や実行環境は別の仕組みで制御します。人間の業務システムでも、利用者の善意だけに頼らず認証・認可・監査ログを組み合わせるのと同じ考え方です。
Googleが想定したのは「返金まで実行する」自律エージェント
Googleの公式例では、顧客から返品依頼を受け、返金額を計算し、データベースへ返金記録を書き込み、結果を利用者へ返すサポートエージェントを題材にしています。
通常時は便利な仕組みですが、外部から入力される文章には悪意ある指示が混ざる可能性があります。たとえば、正規の注文金額を超える返金を要求したり、実行環境の秘密情報を外へ送るコードを実行させようとしたりするケースです。
このような攻撃に対して、「以前の指示を無視しないでください」「注文額以上は返金しないでください」とシステムプロンプトへ書くだけでは、セキュリティ境界としては弱いとGoogleは説明しています。
理由は、システムプロンプトがアプリケーションコードのif文やデータベース制約のような強制ルールではないからです。モデルは自然言語を解釈して実行経路を決めるため、入力の組み合わせやモデル更新によって挙動が変わる可能性があります。
そこで、モデルが突破される可能性を最初から想定し、「突破されても本番データを好き勝手に変更できない」構成にします。これが今回のゼロトラスト設計の中心です。
第1層:データ更新に暗号署名を付ける
複数のAIエージェントが同じデータベース接続を共有している構成では、「どのエージェントがこの変更を行ったのか」を後から確実に証明しにくくなります。アプリケーションログには名前が残っていても、ログ自体が改変されたり、別のプロセスが同じ認証情報を使ったりすれば追跡が難しくなります。
Googleが示した方法では、状態を変更するリクエストごとにエージェント固有の鍵で署名します。データベース側の入口で署名を検証し、正しい署名がなければ更新を受け付けません。
Google Cloudの本番例では、Cloud KMSの非対称鍵とCloud HSMを利用し、エージェントごとに専用のService Accountと署名権限を割り当てています。秘密鍵をコンテナ内へ直接置かず、HSM内から外へ出さない構成です。
この設計の利点は、単なる「誰が操作したか」というログだけでなく、データそのものと署名を結び付けられる点です。返金額や注文IDなどのペイロードを署名対象にすれば、後から金額だけ書き換えられた場合には署名検証が失敗します。
つまり、監査ログを残すだけではなく、「この内容をこのエージェントが承認した」という暗号学的な証拠を持たせる考え方です。
実務で必ずCloud KMSを使わなければならないわけではありません。重要なのは、エージェントごとにIDを分離し、重要な書き込みへ検証可能な証跡を残すことです。小規模なシステムでも、サービスアカウントを共用せず、更新API側で呼び出し元を検証し、監査ログを別系統へ保存するだけでも一歩前進します。
第2層:AIが生成したコードをgVisorで隔離する
AIエージェントがPythonなどのコードをその場で生成して実行する場合、実行環境の設計は特に重要です。生成コードをホストOS上でそのまま実行したり、広い権限を持つコンテナで実行したりすると、プロンプトインジェクションがそのままサーバー侵害につながる可能性があります。
Googleの例では、生成コードをgVisorのユーザー空間カーネルで隔離し、さらにネットワークを無効化、Linux capabilityを削除、メモリとCPUを制限、実行時間にもタイムアウトを設定しています。
ここで重要なのは、「Dockerコンテナに入れたから安全」と考えないことです。通常のコンテナはホストのLinuxカーネルを共有するため、設定ミスやカーネル脆弱性がある場合には影響範囲が広がる可能性があります。
gVisorはアプリケーションとホストカーネルの間にユーザー空間のカーネルを置き、システムコールを仲介します。AIが動的に生成した信頼できないコードを実行する場面では、通常コンテナより強い隔離を検討する理由があります。
ただし、gVisorを入れればすべて安全になるわけではありません。ネットワーク接続を本当に必要とする処理もありますし、ファイルシステム、環境変数、クラウドメタデータサービスへのアクセスなども別途設計が必要です。
SE実務では、まず「AIにコード実行を許可する必要が本当にあるか」を確認する方が先です。計算だけなら専用関数へ置き換えられないか、SQL生成なら実行可能な文を制限できないか、読み取り専用APIで済まないかを検討します。
自由なコード実行は便利ですが、AIエージェントの権限としてはかなり強力です。必要な場合だけ隔離環境を用意し、ネットワーク、CPU、メモリ、時間、マウント領域を最小化するのが基本になります。
第3層:LLMの前後に決定論的な検証を置く
3つ目は、モデルの入力と出力をそのまま外部システムへ流さず、途中に検証ゲートウェイを置く方法です。
Googleの例では、機密情報のパターン、代表的なプロンプトインジェクションの表現、返金上限を超える更新などをルールで検査しています。ルールに違反した場合は、LLMの判断とは関係なく処理をBLOCKします。
ここで「決定論的」という言葉が重要です。同じ入力なら同じ結果になる検証を用意し、「モデルが今回は大丈夫だと判断したから通す」という設計にしません。
たとえば返金額の上限が注文金額までと決まっているなら、モデルへ「上限を守ってください」とお願いするだけではなく、更新API側で数値を比較して超過を拒否します。APIキーらしい文字列を外へ送ってはいけないなら、出力前に検査してブロックします。
これは従来の業務システム開発と同じです。入力チェック、認可、業務ルール、DB制約をAI導入によって捨てるのではなく、むしろAIが柔軟だからこそ厳格な検証を外側へ置きます。
Googleはさらに、こうしたセキュリティポリシーをCI/CDのテスト対象にする方法を示しています。モデルやプロンプトを更新するたびに、既知の攻撃パターンや禁止操作がきちんとブロックされるか自動テストする考え方です。
なぜ3層を組み合わせる必要があるのか
署名、サンドボックス、入出力検証は、それぞれ守れる範囲が異なります。
暗号署名は、どのエージェントがどの内容を書き込んだかを確認するのに有効ですが、危険なコード実行そのものを止める仕組みではありません。
サンドボックスは生成コードによるホスト侵害や外部通信のリスクを減らせますが、「本来149ドルまでの返金なのに1万ドルを書き込もうとしている」といった業務上の正しさまでは判断しません。
入出力ゲートウェイは業務ルールを強制できますが、すべての未知の攻撃を正規表現やルールだけで検出できるわけではありません。
そのため、1つの防御に依存せず、失敗しても次の層で止める構成が必要です。これはDefense in Depth、つまり多層防御の考え方です。
AIエージェントでは「モデルが賢くなれば安全対策が減る」のではなく、モデルが実行できる範囲が広がるほど、外側の制御も強くする必要があります。
SE実務ではどこから取り入れるべきか
Googleの例は本格的ですが、すべての案件でいきなりCloud HSMやgVisorを導入する必要はありません。システムのリスクに応じて段階的に取り入れる方が現実的です。
読み取りと書き込みを分ける
最初に確認したいのは、AIエージェントへ書き込み権限が本当に必要かです。ログ検索、コード調査、ドキュメント検索などは読み取りだけで価値を出せることがあります。
更新が必要な場合も、AI自身にDB権限を渡すのではなく、用途を限定したAPIを経由させる方が管理しやすくなります。
高リスク操作は人間の承認を残す
返金、本番デプロイ、ユーザー削除、権限変更など、失敗時の影響が大きい操作は自動実行させず、人間の確認を挟む設計が有効です。
ゼロトラストは「全部自動化するための技術」ではありません。必要な場所では承認を要求することも重要な制御です。
エージェントごとに認証情報を分ける
複数のエージェントが同じAPIキーやDBユーザーを使っていると、事故が起きたときに原因を追いにくくなります。可能ならサービスアカウント、ロール、秘密情報を役割ごとに分離します。
AIの出力を通常の入力として検証する
AIが生成したSQL、APIパラメータ、ファイルパス、シェルコマンドも、外部入力と同じように扱うべきです。「AIが作ったから信頼できる」ではなく、型、範囲、権限、許可リストを確認します。
フリーランスSEが小規模案件で使うなら
小規模な案件では、Googleの本番構成をそのまま採用するとコストや運用負荷が大きすぎる場合があります。それでも設計思想は利用できます。
たとえば、顧客問い合わせをAIで分類するシステムなら、最初はチケットへタグを付けるだけにし、メール送信や返金処理は人間が行う。コード修正エージェントなら、PR作成までは許可しても本番マージやデプロイは人間が行う。このように権限を段階的に広げる方法です。
また、AIエージェント用のAPIキーを普段の管理者アカウントと分け、利用可能なAPIを必要最小限にします。クラウドIAMを使えるなら専用ロールを作り、ファイル操作なら専用ディレクトリだけをマウントします。
「高度なセキュリティ製品を買えないから対策できない」と考える必要はありません。読み取り専用、専用アカウント、許可リスト、承認フロー、操作ログ、タイムアウトといった基本だけでも被害範囲はかなり変わります。
導入時に起こりやすい失敗
システムプロンプトを権限制御として扱う
「本番データを削除しない」と書くだけでは、削除権限そのものは残っています。禁止したい操作はIAM、API、DB権限などで実行不能にする方が安全です。
共通の管理者権限をエージェントへ渡す
開発が早いからと管理者権限をそのまま使わせると、誤動作時の被害が最大になります。PoCの段階から、本番と同じ最小権限の考え方を入れておく方が後で修正しやすくなります。
サンドボックス内だから外部通信も許可する
隔離環境でも自由な外部通信が可能なら、取得した秘密情報を外へ送信される経路が残ります。必要な通信先だけを許可する、または処理によってはネットワークを完全に無効化する判断が必要です。
検出ルールだけを増やして安心する
既知の攻撃語句を大量に登録するだけでは、新しい表現や別言語の入力を完全には防げません。業務上の上限値、許可API、型、権限など、攻撃文の表現に依存しないルールを優先した方が堅牢です。
向いているシステム・まだ早いシステム
今回の構成が特に参考になるのは、AIエージェントが本番状態を変更するシステムです。返金、注文変更、データ更新、クラウド操作、コード実行、CI/CD、社内業務ワークフローなどが該当します。
一方、社内文書の検索や要約だけを行うシステムで、外部への書き込みもコード実行もない場合は、同じ強度の仕組みをすべて入れる必要はないでしょう。認証、データアクセス制御、ログ、入力情報の管理を優先する方が実用的です。
重要なのは、「AIだから特別なセキュリティ製品が必要」と考えるのではなく、AIが持つ権限と失敗時の影響を見て必要な防御を決めることです。
これからAIエージェントを本番導入するなら確認したいこと
本番導入前には、最低でも次の点を整理しておくと安全設計を進めやすくなります。
- AIエージェントが読み取れるデータは何か
- 書き換えられるデータは何か
- 外部通信先を限定できるか
- コード実行は本当に必要か
- 利用する認証情報は専用化されているか
- 高リスク操作に人間の承認があるか
- 操作履歴を後から追跡できるか
- モデルやプロンプト更新時にセキュリティ回帰テストを行えるか
- 異常時にエージェントの権限をすぐ停止できるか
最初から完全自律を目指すより、読み取り、提案、承認付き実行、自動実行という順に段階を上げる方が、問題の発見と切り分けがしやすくなります。
まとめ
Googleが2026年8月17日に公開したADKのゼロトラスト構成は、AIエージェントの安全性をモデル自身の判断だけに任せない設計を具体化したものです。
中心となるのは、エージェントごとの暗号署名による書き込み検証、gVisorを使ったコード実行の隔離、LLMの前後に置く決定論的な入出力検証の3層です。それぞれ役割が異なるため、1つだけ導入するより多層で組み合わせる方が強い設計になります。
SE実務で最も参考になるのは、「AIを信用できるか」を議論するより、「AIが間違えても何をできないようにするか」を先に決める考え方です。読み取り専用から始め、専用ID、最小権限、承認、サンドボックス、検証ルール、監査ログを段階的に追加する方が現実的です。
AIエージェントの能力が上がるほど、自由度だけでなく制御の設計が重要になります。本番システムへ接続する前に、モデルの性能ではなく、権限境界と失敗時の被害範囲を確認することが導入の第一歩です。
参考情報
- Google Developers Blog: Build zero-trust AI agents with Google’s Agent Development Kit
- Google Agent Development Kit Documentation
- Google ADK Samples
確認日:2026年8月21日。サービス仕様やGoogle Cloudの提供条件は変更される可能性があります。実装時は最新の公式ドキュメントを確認してください。
コメント