
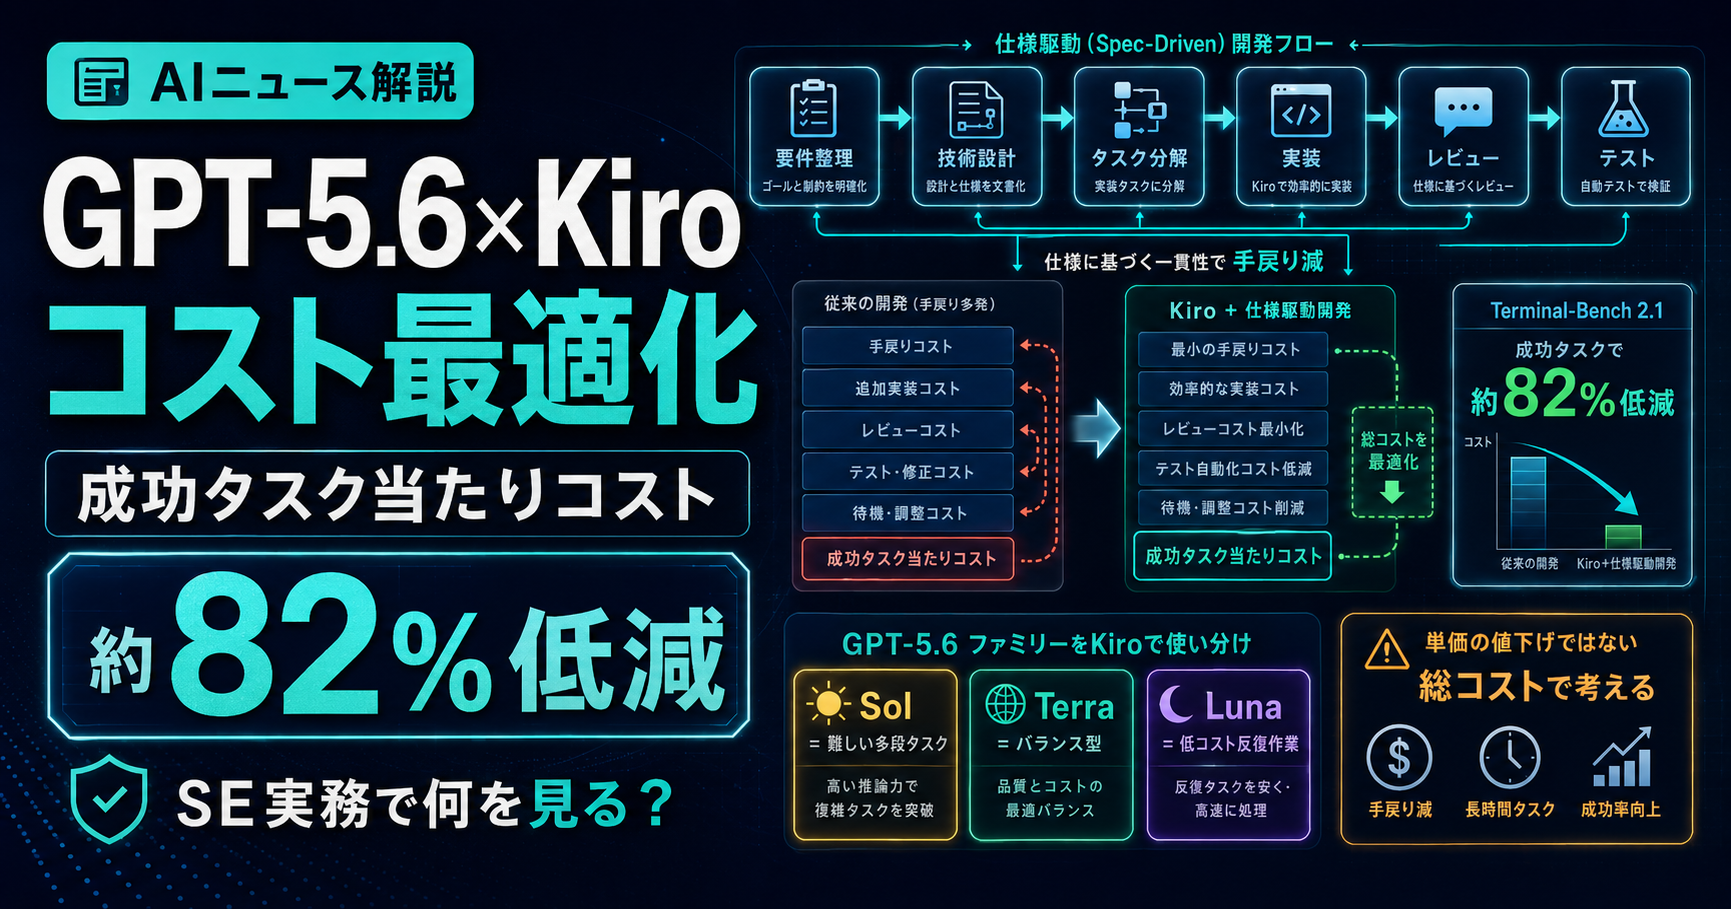
OpenAIは2026年8月24日、AWSのAI開発エージェント「Kiro」でGPT-5.6ファミリーを活用する取り組みを発表しました。
今回のポイントは、単に「KiroでGPT-5.6が使える」という話ではありません。Kiro側では7月14日の時点でGPT-5.6 Sol・Terra・Lunaの提供が始まっており、7月31日にはTerraとLunaのクレジット倍率も引き下げられていました。8月24日のOpenAI発表では、OpenAIとAWSがKiro環境とGPT-5.6を共同で最適化し、仕様駆動開発や長時間タスクで、より少ない手戻りとコストで成果を出す方向性が強調されています。
特に注目したいのが、Terminal-Bench 2.1を使ったテストで、GPT-5.6 TerraがKiro上で成功したタスクについて、約82%のコスト削減が確認されたという説明です。これは「API単価が安くなった」という意味ではなく、1つの開発タスクを完了させるまでに必要な総コストを見る考え方です。
SEやフリーランス開発者にとっては、モデルのベンチマーク順位よりも、実際の業務で何回やり直しが発生し、どれだけ長くエージェントを走らせ、最終的にいくらで作業を完了できるかの方が重要です。2026年8月25日時点の公式情報を基に、今回の発表を実務目線で整理します。
8月24日の発表で何が新しかったのか
OpenAIの発表では、GPT-5.6 Sol・Terra・LunaをKiroの開発フローで利用し、要件整理、技術設計、実装タスク、レビュー、テストまでを一連の流れとして支援できる点が紹介されています。
Kiroは、曖昧な依頼をそのままコード生成へ渡すのではなく、要件を整理し、技術設計に落とし込み、実行可能なタスクへ分解する「spec-driven development(仕様駆動開発)」を重視する開発エージェントです。つまり、モデルにいきなり「作って」と頼むよりも、先に何を作るか、どう動くべきか、どこまでを完了条件とするかを構造化してから実装へ進みます。
今回のOpenAI発表で新しいのは、このKiroの構造化された開発フローとGPT-5.6を組み合わせた際の価値を、OpenAIとAWSの共同最適化という形で明確に打ち出した点です。
OpenAIはKiro上でGPT-5.6を使うことで、製品アイデアや要求から実装計画を作る、複雑な多段タスクを進める、コードベースやチーム標準を踏まえる、実装前の重要なチェックポイントで人間がレビューする、property-based testingで正しさを確認するといった使い方を挙げています。
「約82%コスト削減」はどう読むべきか
今回もっとも目を引く数字が「約82%のコスト削減」です。ただし、この数字は読み方を間違えない方がよいでしょう。
OpenAIの説明では、Terminal-Bench 2.1のテストにおいて、GPT-5.6 TerraがKiro上で成功したタスクについて、コストが約82%低減したとされています。ここで重要なのは、GPT-5.6 TerraそのもののAPI料金が82%下がった、という話ではないことです。
AIコーディングエージェントのコストは、1回のモデル呼び出し料金だけでは決まりません。途中で方針を間違えて何度もコードを書き直したり、不要なファイルを読み込んだり、同じテストを何度も実行したりすれば、総トークン量やツール呼び出し回数は増えます。
逆に、最初に要件と設計を整理し、モデルが必要な文脈を理解した状態でタスクを進められれば、1回あたりのモデル単価が同じでも、最終成果物までの総コストは下がる可能性があります。
SE実務で見るべき指標は「1リクエストいくら」だけではなく、1件の障害修正、1つの機能追加、1回のリファクタリングを完了させるのに最終的にいくらかかったかです。今回の発表は、その考え方を強く示す内容といえます。
KiroではSol・Terra・Lunaをどう使い分けるか
Kiroの公式ドキュメントでは、GPT-5.6 Sol・Terra・Lunaを用途とコストのバランスで使い分ける形が示されています。
| モデル | Kiroでの位置づけ | クレジット倍率 | 向いている作業 |
|---|---|---|---|
| GPT-5.6 Sol | 最も難しい多段タスク向け | 2.4x | 長期リファクタリング、複雑な端末作業、難しい設計 |
| GPT-5.6 Terra | 性能とコストのバランス型 | 1.0x | 日常的な多段開発、通常の実装・修正 |
| GPT-5.6 Luna | 低コスト・高頻度向け | 0.1x | 繰り返し処理、軽量な修正、スループット重視の作業 |
2026年8月25日時点のKiroドキュメントでは、3モデルともKiro上のコンテキストは272Kで、FreeではなくPro、Pro+、Pro Max、Powerが対象です。またGPT-5.6系の推論は、Kiroプロフィールの地域にかかわらず米国側で処理されると記載されています。
業務データや顧客コードを扱う場合は、このデータ処理地域も導入前に確認しておきたい項目です。チームや企業のセキュリティ基準によっては、モデル性能より先にデータ所在地や契約条件が判断材料になります。
最初からSolへ固定するより、通常タスクはTerra、軽量な繰り返し作業はLuna、難所だけSolへ切り替える方が、クレジット消費を管理しやすいでしょう。KiroにはAutoもあり、モデル選択を自動化する方法も用意されています。
仕様駆動開発がAIエージェントと相性がよい理由
生成AIによるコーディングで起こりやすい失敗の一つは、要求が曖昧なまま実装を始めることです。
たとえば「管理画面にCSV出力を追加して」とだけ依頼すると、対象データ、権限、文字コード、列順、ファイル名、最大件数、タイムアウト時の扱いなど、実務では決めるべきことが多数あります。人間同士でも認識がずれる内容を、AIが自動的に正しく補完できるとは限りません。
Kiroのように、要件、設計、タスクへ段階的に分ける方法なら、実装前に曖昧さを見つけやすくなります。AIエージェントが長時間自律実行できるようになるほど、「速くコードを書けるか」よりも「間違った方向へ長時間走らせないか」が重要になります。
フリーランスSEの案件でも同じです。依頼内容をそのままAIへ渡すのではなく、受け入れ条件、変更対象、触ってはいけない範囲、テスト方法を先に整理しておけば、レビュー時の確認項目も明確になります。
これはAI専用の新しい開発手法というより、従来から重要だった要件定義や設計の価値が、エージェント時代にさらに大きくなったと考える方が自然です。
SE実務で試すなら小さな完結タスクから
KiroとGPT-5.6を試すなら、最初から大規模な新規開発を丸ごと任せる必要はありません。むしろ、完了条件が分かりやすい小さなタスクで比較した方が、効果を判断しやすくなります。
たとえば、既存APIへ入力チェックを1項目追加する、既知の不具合を再現して修正する、ユニットテストが不足している関数へテストを追加する、古いライブラリ呼び出しを一部置換する、といった作業です。
その際は「完成したかどうか」だけでなく、次の数値を残しておくと比較しやすくなります。
- 完了までの所要時間
- 消費クレジット
- 人間が修正した箇所数
- テスト失敗回数
- エージェントへの追加指示回数
- レビューで見つかった問題数
これをTerra、Sol、Autoなどで比較すれば、「一番賢いモデル」ではなく「自分の案件で最も費用対効果がよい設定」を見つけられます。
特にフリーランスでは、AIツールの月額料金だけを比較するより、作業時間が何分減ったか、手戻りが何回減ったかまで含めて見る方が、導入判断につながります。
導入前に確認したい注意点
今回の発表は有望ですが、公開ベンチマークの結果だけで本番導入を決めるのは避けた方が安全です。
Terminal-Bench 2.1はAIエージェントの端末操作能力を見るための評価ですが、自社のJavaシステム、独自フレームワーク、日本語仕様書、古い基幹システムで同じ改善率になる保証はありません。約82%という数字も、すべての開発作業で再現されるものではありません。
またKiroではモデルごとにクレジット倍率が違うため、Solを多用すれば消費は増えます。反対にLunaが0.1xでも、難しいタスクで何度も失敗してやり直せば、最終コストが安くなるとは限りません。
企業利用では、ソースコードや設定ファイルに秘密情報が含まれていないか、外部AIサービスへ送信してよい情報か、どの地域で処理されるか、ログや監査要件を満たせるかも確認が必要です。
AIコーディングエージェントは、便利だから全面的に任せるのではなく、実行権限、変更可能なディレクトリ、レビュー必須の工程、テスト条件を明確にしたうえで使う方が安全です。
今回の発表から見えるAI開発ツールの選び方
AI開発ツールを選ぶとき、これまでは「どのモデルが一番高性能か」「月額はいくらか」が比較の中心になりがちでした。
しかしエージェント型の開発が増えると、評価軸は変わってきます。モデル単体の性能だけでなく、要件をどう整理するか、コードベースの文脈をどう渡すか、途中で人間がどこを確認するか、テストをどう自動化するかまで含めた開発フロー全体が成果を左右します。
今回のOpenAIとAWSの発表で興味深いのは、GPT-5.6そのものではなく、Kiroという実行環境と組み合わせることで「成功タスク当たりのコスト」を下げる方向を示した点です。
今後AI開発ツールを比較するときは、月額やモデル名だけでなく、次の観点を見ると実務に近い評価になります。
- 1つのタスクが完了するまでの総コスト
- 長時間タスクでの中断や迷走の少なさ
- 仕様やチームルールをどこまで保持できるか
- レビューや承認ポイントを設定できるか
- テストまで含めて完了条件を確認できるか
- モデルを用途別に切り替えられるか
「高性能なモデルを使う」だけでは、AIエージェントの導入効果は測れません。開発プロセス全体で、手戻りと人間の確認工数をどれだけ減らせるかを見る必要があります。
まとめ
OpenAIが2026年8月24日に発表したGPT-5.6とKiroの取り組みは、AIコーディングの評価軸が「モデル性能」から「開発タスクを完了するまでの総効率」へ移っていることを分かりやすく示しています。
特に、Kiroの仕様駆動開発で要件、設計、実装タスクを先に整理し、GPT-5.6をその文脈に沿って動かす考え方は、長時間動くAIエージェントほど重要になります。
SE実務で試すなら、まずは完了条件が明確な小さな修正を対象にし、TerraやAutoを基準として、必要な場合だけSolを使う方法が現実的です。評価するときは、モデルの回答品質だけでなく、完了時間、消費クレジット、再指示回数、人間の修正量まで記録すると判断しやすくなります。
AI開発ツールの本当のコストは「1回いくら」ではなく、「仕事を1件終わらせるのにいくらか」です。今回の発表は、その視点でコーディングエージェントを評価する材料になります。
コメント