
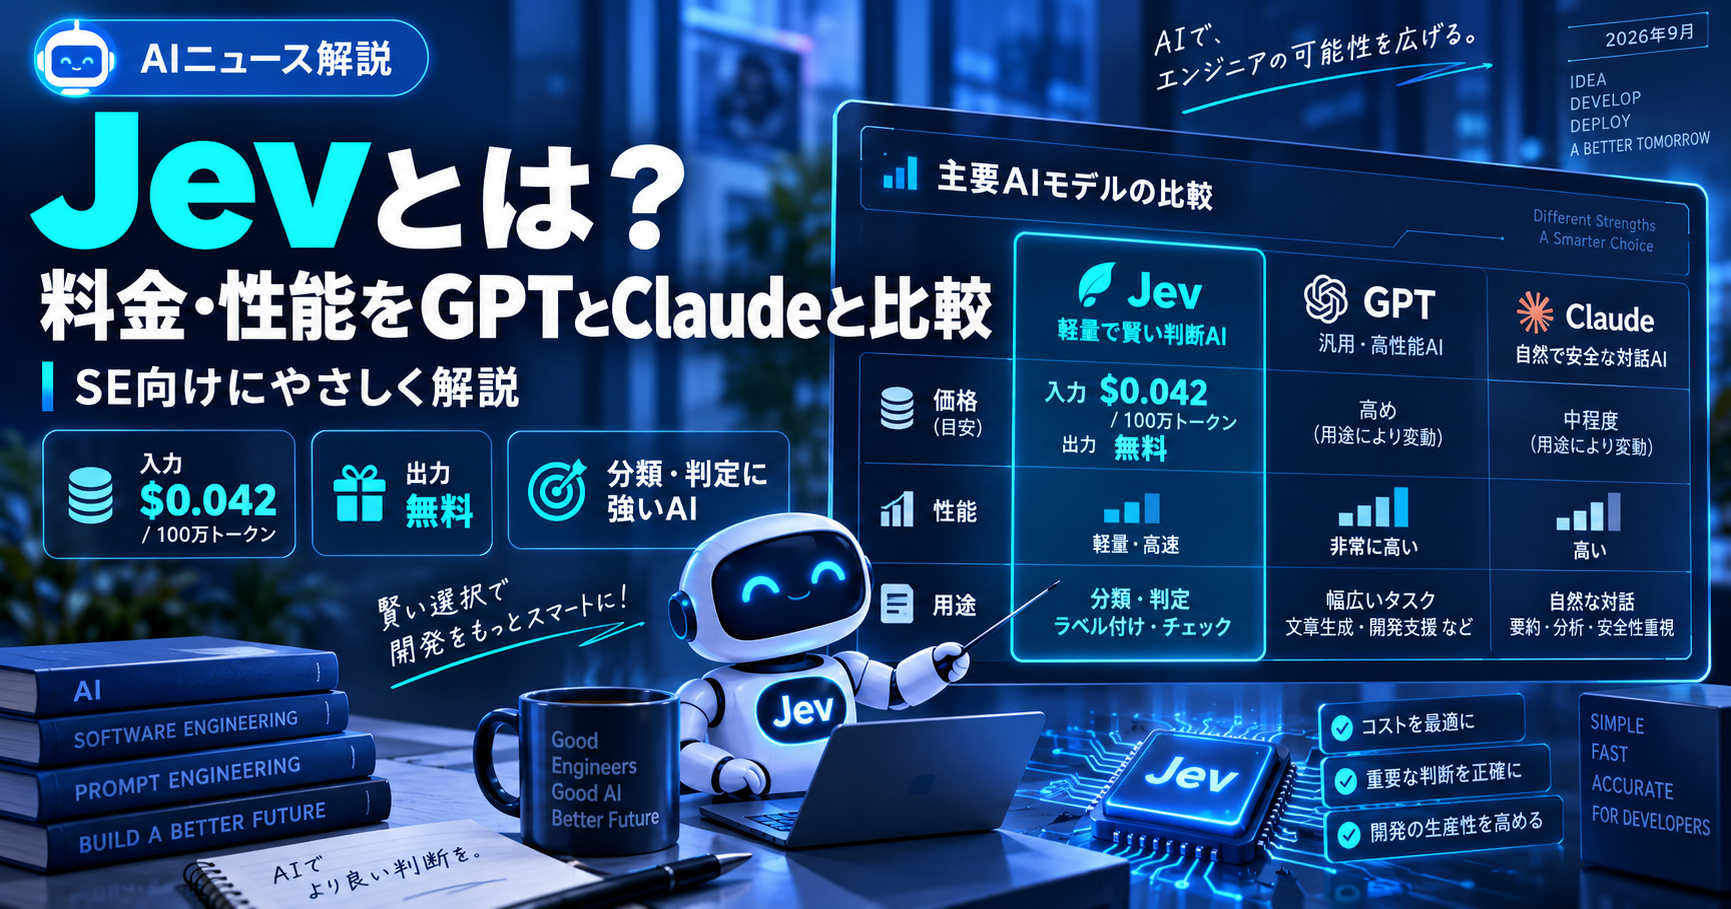
情報確認日:2026年9月17日。「JevはGPTやClaudeより数百倍安いらしい。では、普段のチャットAIやコーディングAIの代わりになるのか」。気になるところですが、料金だけを比較すると判断を誤ります。Jevは文章を書くモデルではなく、システムの中で必要になる小さな判断を高速に返すモデルだからです。
TypeSafe AIは2026年9月15日、同社初の「System One Model」であるJevを発表しました。公式発表による料金は入力100万トークン当たり0.042米ドル、出力トークンは無料。分類・振り分け・スコア付けといった用途に限定すれば、OpenAIやAnthropicの汎用モデルとは異なる選択肢になります。ただし、正確性が無条件で高いわけではなく、2026年9月17日時点では早期アクセスのウェイトリスト制です。TypeSafeの公式発表と公式ドキュメントを基に、実務での判断材料を整理します。
Jevとは?一言で言えば「プログラムに組み込む判定AI」
GPTやClaudeは質問への回答、文章要約、コード生成など、自由な文字列を返せます。一方、Jevは最初に指定された形式の値だけを返します。入力された状況(state)に対し、複数の質問(questions)を並列に評価し、選択肢や数値、確率を返す仕組みです。TypeSafeはこれを「文章ではなく、ソフトウェアがそのまま利用できる判断」と説明しています。
たとえば問い合わせメールを受け取ったシステムなら、「請求・技術・営業のどこへ振り分けるか」「緊急性が高いか」「不満の強さはどの程度か」を一度に質問できます。戻ってきた結果を使い、プログラムが担当窓口への振り分けや人への確認依頼を実行します。回答文そのものを作りたいときはGPTやClaudeなど別のモデルを担当させる構成です。
公式APIで使う質問形式は3種類あります。Choiceはあらかじめ定義した選択肢から選び、その選択肢ごとの確率とconfidenceを返します。Scoreは決めた尺度で採点し、スコアと分布などを返します。NoulはYes/Noに相当する問いに0〜1の確率で答え、別個のconfidence項目は返しません。形式の違いは公式の質問形式一覧で確認できます。
この設計では、定義されていない選択肢や想定外の型を返さないという強みがあります。ただし、「出力形式を守る」ことと「選んだ答えが正しい」ことは別です。選択肢が「請求」「技術」「営業」の3つに限定されていても、実際は請求担当が適切な問い合わせを技術担当と誤判定する可能性は残ります。公式サイトが使う「幻覚ゼロ」という表現を、誤判定ゼロや事実誤認ゼロと受け取らないことが大切です。
何に使える?SE・フリーランスSEが考えたい5つの用途
Jevが活きるのは、大量のデータを毎回似た基準で判断し、次の処理へつなぐ場面です。以下は公式の用途説明を踏まえた導入案であり、このブログで実際にJevを動かして検証した結果ではありません。
1.障害ログ・問い合わせチケットの一次振り分け
監視ログや障害受付文から「要調査か」「どのチームの担当か」「顧客影響がありそうか」を判定します。定型的なログの集計は従来のコードで処理し、文章のニュアンスが必要な箇所だけJevに任せるのが現実的です。深刻度が高い、または判断に迷う案件は担当者へ回す設計にします。
2.AIエージェントの実行前・実行後チェック
CodexやClaude Codeなどが提案した操作について、「破壊的変更が含まれるか」「依頼範囲を超えていないか」といった観点を別の判定工程で確認する使い方です。ただしJevの判定だけをセキュリティ保証としないでください。権限管理、テスト、承認フローは別途必要です。TypeSafeの公式資料も、判定結果と信頼度をコード側の閾値に結び付ける設計を提示しています。
3.検索結果やRAGの候補文書の絞り込み
検索で候補を集めた後、「質問に答える根拠が含まれるか」「関連性は高いか」などを判定し、回答生成モデルへ渡す文書を選びます。Jev自体が長い解説文を生成するのではなく、検索と回答生成の間に挟む部品です。誤って重要な根拠を落とす可能性があるため、候補の再現率も検証します。
4.請求書・事務処理の例外検知
請求内容と発注情報の不一致などをチェックし、「自動処理」「保留」「人の確認」の分岐に利用する構成が考えられます。ただし支払金額・税額などの確定計算はAIではなく通常のプログラムに任せるべきです。誤判定が金銭的損失につながる処理では、一定の条件で必ず人が確認する運用を前提にします。
5.大量の文章の品質・ポリシーチェック
作成済み文書に対し、「根拠のない断定があるか」「表現上の問題があるか」など複数の質問をまとめて投げる用途です。これは文章を書く作業ではなく、既存文章の点検です。検知結果は修正候補として扱い、最終的な判断や内容の訂正は人または別の検証工程で行います。
逆に、質問への説明文、記事、メール、プログラムのソースコードを直接作りたい人にはJev単体では対応できません。単純な完全一致判定や数値比較で済む処理も、わざわざ外部AIへ送るより、普通のif文や正規表現の方が検証しやすい場合があります。
Jevはいくら安い?GPT・ClaudeのAPI公式料金と比較
次の表は2026年9月17日に確認できた公表価格です。通貨は米ドルで、いずれも標準的な入力・出力100万トークン当たりの価格を示します。ChatGPTやClaudeの月額サブスクリプション料金ではありません。キャッシュ・バッチ・特別な利用条件による割引、追加ツール料金などは含めず、トークン単価の比較です。Jevの「出力無料」は文章を生成できることを意味しません。
| モデル | 入力100万トークン | 出力100万トークン | 用途・備考 |
|---|---|---|---|
| TypeSafe Jev | $0.042 | 無料 | 型付きの判定・分類。早期アクセス |
| OpenAI GPT-5 nano | $0.05 | $0.40 | 旧世代だが入力単価が近い低価格モデル |
| OpenAI GPT-5.6 Luna | $0.20 | $1.20 | 高頻度・低コスト用途の汎用モデル |
| OpenAI GPT-5.6 Terra | $2.00 | $12.00 | 知能とコストのバランスを重視 |
| OpenAI GPT-5.6 Sol | $4.00 | $20.00 | 複雑な業務向け汎用モデル |
| Anthropic Claude Haiku 4.5 | $1.00 | $5.00 | 低価格帯の汎用モデル |
| Anthropic Claude Sonnet 5 | $2.00 | $10.00 | 汎用・開発業務にも対応 |
| Anthropic Claude Opus 5 | $5.00 | $25.00 | 複雑な業務向け汎用モデル |
出典:TypeSafe公式発表、OpenAIのGPT-5 nano料金、OpenAIモデル一覧、Anthropic公式API料金表。Anthropicの古い日本語ページなどには過去の期間限定価格が残る場合があるため、更新された公式英語版で照合しました。
入力単価だけなら、JevはGPT-5 nano($0.05)の約1.2分の1、GPT-5.6 Luna($0.20)の約4.8分の1、GPT-5.6 Terra($2)の約47.6分の1、Claude Haiku 4.5($1)の約23.8分の1、Claude Sonnet 5($2)の約47.6分の1です。TypeSafeが打ち出す「Claude Fable 5.1より入力単価238倍安い」という比較も、Fable 5.1の入力単価$10に対するものです。比較相手を最廉価級のモデルに変えると、倍率は大きく縮みます。
たとえば、月間で入力1,000万トークンを使う場合、入力料金だけの単純計算ではJevは$0.42、GPT-5 nanoは$0.50、GPT-5.6 Lunaは$2.00、Claude Haiku 4.5は$10.00です。ここに汎用LLMでは出力料金が加わります。ただし実際の月額は、1件当たりの入力長、何回呼び出すか、キャッシュ、再判定、人手へのエスカレーションなどで変わります。Jevで判定した後に別のLLMで文章を生成する構成なら、そのLLM料金も必要です。
「40〜400倍安い」「約444.6倍安い」という宣伝値は、TypeSafeが設定した特定のワークフロー全体での比較であり、あらゆる業務・あらゆるモデルに対する固定の価格差ではありません。特に日常的な少量利用では、単価差よりも実装・保守の手間が費用に効くことがあります。
性能はどの程度?OpenAI・Anthropicと比較した公開ベンチマーク
「GPTやClaudeと同程度の性能」と言うには、何を測った数字なのかを確認する必要があります。TypeSafeはセキュリティインシデント、AIエージェントの実行記録チェック、請求書処理、カスタマーサポートという4種類の業務フローを評価しています。各モデルに同じ分解済みワークフローを使わせ、GPT-6 AstraとClaude Fable 5.1の高思考設定で得た回答の平均を参照ラベルとしています。したがって、ここでいう「一致率」は独立した人間の正解データに対する業務上の正答率ではありません。数値はTypeSafeの評価環境における4業務の等重み平均です。評価方法と公開結果を参照してください。
| モデル | 参照回答との一致率 | 1ケース当たり推定費用 | 1ケース当たり処理時間 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4秒 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9秒 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1秒 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3秒 |
| Claude Haiku 4.5 | 53.6% | $0.0195 | 12.5秒 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1秒 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8秒 |
表の数値はTypeSafeのWorkflow evalsで公表された「workflow」方式の値。モデルや測定条件、ページ上のデータは将来変わる可能性があります。LLMの結果もTypeSafe独自の構造化判定用ラッパーを通して測定されているため、各社の通常のチャット画面での体感速度とは比較できません。
この条件では、Jevの一致率67.8%はGPT-5.6 Terraの67.9%とほぼ同水準、Claude Sonnet 5の67.8%と同値です。一方で、GPT-5.6 Solの74.1%やClaude Opus 5の73.1%には届いていません。Jevは「難しい質問にもGPT・Claudeと同じように答える」モデルではなく、あらかじめ分割された判断を、公開評価では低い費用と短い処理時間で実行したモデルと捉えるのが正確です。
費用と時間の倍率を読んでいても注意が必要です。たとえば表のTerraとの比較では、Jevのケース費用は約76分の1、時間は約25分の1です。しかしこれらは発表元が設計した4業務の平均であり、自社のログ分類や日本語の問い合わせでも同じ差になる保証はありません。TypeSafe自身、評価用ワークフローを社内チームが作ったことや、最大の改善倍率が一般的な実運用の上限寄りであることを明記しています。
第三者の実例として、Everyの2026年9月15日公開・16日更新の検証では、37文書にそれぞれ21個の質問を投げた777件の判定を0.7秒未満、推定約0.25セントで実行しています。別の小規模テストでは、意図的に混ぜた7件の文章上の欠点のうちJevが6件、Claude Fable 5.1が7件を検出。Jevの処理時間中央値は1文書0.35秒、Fableは8.83秒でした。速度と価格の利点がうかがえる一方、サンプルが小さく、幅広い業務の精度を証明する数字ではありません。
実際の使い方:ウェイトリスト登録からAPI連携まで
2026年9月17日時点、TypeSafeは開発者向け早期アクセスを提供し、公式サイトからウェイトリスト登録を受け付けています。誰でも申請直後にAPIが使えるという提供形態ではありません。日本からの利用可否・請求条件・日本語の正式対応範囲は、公開資料だけでは十分に確認できないため、アカウントが利用可能になった段階で確認してください。
アクセス権が得られたら、公式のQuick startに従ってPlaygroundで文章と質問を入力するか、APIキーを発行してHTTP APIを呼びます。公式ドキュメントに記載されたエンドポイントはPOST https://api.typesafe.ai/v1/systemone、モデル指定はjev-latestです。Python SDKならpip install typesafe-sdkで導入する方法も案内されています。
概念としては、入力のstateに問い合わせ内容や現在の状況を入れ、questionsに「担当部署を選ぶChoice」「緊急かどうかのNoul」などを定義します。結果の確率に応じて、コードが担当部署へ振り分けたり、人によるレビューへ回したりします。APIキーをソースコードや公開リポジトリへ直接書かず、環境変数・秘密情報管理機構で扱ってください。
注意点は、質問を一度に複数投げられるからといって、複雑な判断を一つの質問に押し込まないことです。公式ドキュメントでは、個別の要素を短い問いに分解し、条件の重み付けや最終判定をコードで組み合わせる設計を勧めています。「障害が重大か」だけでなく「顧客影響があるか」「データ消失のおそれがあるか」「復旧操作に承認が必要か」と分ける方が、判定基準を追跡できます。
導入前に確認したい落とし穴:安さ・確率・データ保護
確率が高くても、100%正しいとは限らない
判定確率の数字を、そのまま業務上の正答率や事故発生率と取り違えないことが重要です。業務で利用するなら、正解の分かっている過去案件を用意し、誤検知と見逃しを別々に集計してください。重大な操作では「確率が一定以上なら自動実行」という単純なルールだけに頼らず、金額上限や禁止操作、承認などの決定的なルールを併用します。Noulの0.5は「普通の深刻度」という意味ではなく、YesとNoの見込みが拮抗している状態です。
型の保証と業務上の安全性を混同しない
選択肢外の文字列を返せない設計は、JSONパース失敗や未定義値への対処を減らすメリットがあります。しかし選択肢そのものを適切に設計していなければ、正しい担当部署が候補にないまま誤った部署を選ぶことになります。「その他」「不明」「人による確認」を分岐として用意できるかを検討しましょう。
個人情報や機密情報の送信には事前確認が必要
TypeSafeのプライバシーポリシーは、入力データをモデルの学習・ファインチューニングに使用しない旨を記載する一方、サービス提供事業者への共有や、必要な期間の情報保持にも言及しています。「学習に使わない」ことは「保存しない」「社外に出ない」こととは違います。顧客名、障害内容、契約書やソースコードを送る前に、契約、データの所在、削除条件、組織の情報管理ルールを確認してください。
日本語性能・運用条件は独自に確かめる
日本語の誤字を含む問い合わせ、社内略語、業界固有の表現などに対する精度は、ここで紹介した公開評価からは判断できません。コンテキスト長、契約・課金の詳細、レート制限も利用可能なプランと実際のAPI仕様で確認が必要です。英語デモの速度を日本からの本番レイテンシとして流用せず、自分たちの環境で計測するべきです。
どんな人に向いている?GPT・Claudeとどう使い分ける?
Jevを試す意味があるのは、問い合わせ分類、ログの優先度判定、検索候補の絞り込みなど、同じ種類の短い判断を大量に繰り返す開発者や運用担当者です。入力件数が多く、判定結果を後続プログラムがそのまま使い、処理遅延やトークン費用が現実の課題になっているなら、比較検証の対象になります。
一方で、要件定義書の作成、設計相談、長い文章の要約、コードの実装と修正、原因を順序立てて説明する作業には、自由文を生成できるGPTやClaudeが必要です。少量の判定しかない案件や、人が毎回結果を確認する案件では、既存のLLMを構造化出力モードで使う方がシステム全体は簡単かもしれません。
実務上の使い分けとしては、「単純な確定ルールは通常のコード」「曖昧で反復する狭い判断はJev」「長文生成や複雑な説明はGPT・Claude」「重大な例外は人」という分担が考えられます。これは設計上の提案であって、Jevがすべての業務で既存モデルより優れるという実証結果ではありません。
フリーランスSEなら、いきなり顧客の本番データを接続するより、公開可能なサンプルや匿名化した過去の問い合わせ50〜100件程度で小規模な比較セットを作る進め方が現実的です。同じ問題をJev、低価格のGPT、既存のルールベース実装に処理させ、誤判定率・処理時間・1件当たり総費用・保守工数を測ります。精度と業務影響を確認してから、本番導入の範囲を決めると説明もしやすくなります。
まとめ:Jevの価値は「安いチャットAI」ではなく「低コストな判断部品」
Jevは入力100万トークン0.042ドル、出力無料という公表価格を持ち、TypeSafeの限定された業務評価ではGPT-5.6 TerraやClaude Sonnet 5に近い参照回答一致率を、より短い処理時間と低い推定費用で示しています。ただし、最高性能の汎用モデルと同等の文章生成・コーディング能力を示したものではありません。また、発表元の評価は人間が確定した正答データではなく他モデルの回答を参照しています。
まずは早期アクセスの提供状況を確認し、アクセスできるようになったら匿名化した少数の実データで「判定の精度」「見逃しが許されるか」「総費用」を比べることが次の一歩です。目指すべきはAIの全面置換ではなく、どの判断をどの仕組みに任せると、安全で説明可能な業務フローになるかを見極めることです。
参考情報・確認先
- TypeSafe公式発表:Introducing System One Models & Jev(2026年9月15日)
- TypeSafe公式サイト:価格・ウェイトリスト
- TypeSafe公式ドキュメント:モデルと質問形式
- TypeSafe Quick start:Playground・API・SDK
- TypeSafe Workflow evals:評価方法と比較結果
- OpenAI公式モデル一覧・API料金
- OpenAI公式:GPT-5 nano
- Anthropic公式:Claude API Pricing
- Every:Jevの第三者検証(2026年9月15日、16日更新)
- TypeSafe公式プライバシーポリシー
料金・モデル仕様・提供状況は2026年9月17日時点の確認内容です。製品の変更により異なる場合があります。実際の契約・運用時は各公式ページの最新条件を再確認してください。
コメント