
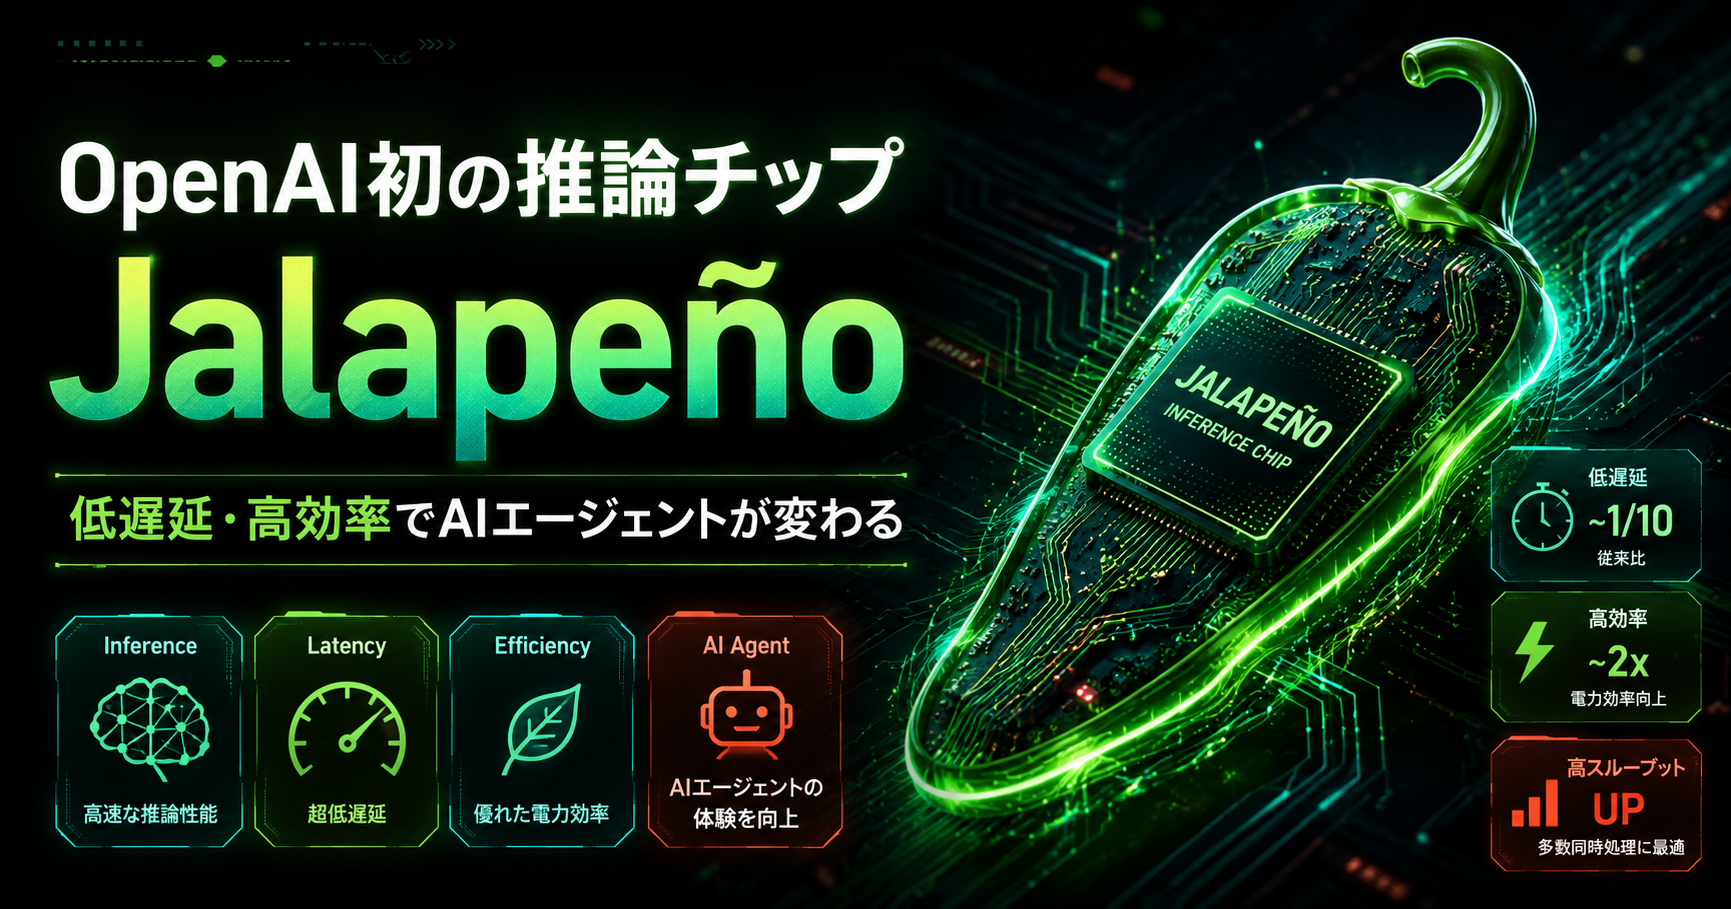
OpenAIは2026年8月25日、同社初のカスタム推論チップ「Jalapeño(ハラペーニョ)」について、初めて具体的な性能測定結果を公開しました。
今回の発表で注目したいのは、単に「OpenAIが自社チップを作った」という点ではありません。OpenAIはJalapeñoを、AIモデルの学習用ではなく、完成したモデルを実際のサービスで動かす推論処理に最適化したチップとして位置づけています。
公式発表によると、GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tを使ったInferenceXベンチマークで、比較対象の商用システムに対し、ピーク時の1ワット当たりAI処理量が1.5〜1.9倍、エンドツーエンドの遅延が1.7〜3.6倍低い結果になりました。高い対話性が必要なワークロードでは2.1〜4.1倍の性能を示したとされています。
ただし、この数字を「ChatGPTが明日から3倍速くなる」「API料金がすぐ下がる」と読むのは早計です。公開されたのは特定条件下の推論ベンチマークであり、Jalapeñoは2026年末までにOpenAIの計算基盤へ導入を始める計画段階です。
SEにとって重要なのは、AIサービスの性能がモデルだけで決まらず、チップ、メモリ、ネットワーク、推論ソフトウェアまで含む「全体設計」で大きく変わることです。特に複数ステップを連続実行するAIエージェントでは、1回ごとの小さな遅延が積み重なるため、推論基盤の効率は実務体験に直結します。
Jalapeñoとは何か
Jalapeñoは、OpenAIが自社のAIワークロード向けに設計した最初のカスタム推論チップです。
AIの計算には大きく分けて「学習」と「推論」があります。学習は大量のデータを使ってモデルそのものを作る処理です。一方の推論は、完成したモデルに入力を渡し、文章やコード、判断結果を返してもらう処理です。
私たちがChatGPTに質問する、APIからモデルを呼び出す、コーディングエージェントにコードを修正させる、といった日常的な利用の多くは推論に当たります。
生成AIの利用者が増え、AIエージェントが1つの依頼で何十回、何百回とモデルを呼び出すようになると、推論側の計算負荷は非常に大きくなります。モデルが賢くなっても、推論基盤が遅かったり電力効率が悪かったりすれば、サービス全体の応答速度や提供コストが悪化します。
OpenAIはJalapeñoについて、モデル、推論ソフトウェア、チップ、メモリ、ネットワーク、ラック単位のシステムを一体で設計することで、スループットと低遅延を両立させることを狙ったと説明しています。
つまりJalapeñoは、単体のチップ性能だけを競う製品というより、OpenAIが自社サービス全体を効率化するための専用基盤の一部と見る方が分かりやすいでしょう。
今回公開されたベンチマーク結果
OpenAIは、SemiAnalysisが提供する公開ベンチマーク「InferenceX」を使ってJalapeñoを評価しています。
対象になった公開モデルは次の3つです。
- GPT-OSS 120B
- DeepSeek R1 670B
- Kimi K2.5 1T
OpenAIの公開結果では、3モデル全体で、Jalapeñoは比較対象の商用システムに対してピーク時の1ワット当たりAI処理量が1.5〜1.9倍、エンドツーエンド遅延が1.7〜3.6倍低い結果になりました。また、高い対話性を重視する条件では2.1〜4.1倍の性能を示したと説明されています。
個別の例では、GPT-OSS 120Bで比較対象のGB200に対し、ピーク時のmixed TPS/kWが約1.9倍、エンドツーエンド遅延は1.03秒対1.80秒でした。
DeepSeek R1 670BではGB300との比較で、ピーク時のmixed TPS/kWが約1.7倍、エンドツーエンド遅延は1.65秒対5.99秒。Kimi K2.5 1Tでは約1.5倍のピーク性能/ワットと、1.56秒対5.31秒の遅延結果が示されています。
Jalapeñoの公称チップ電力は700Wですが、OpenAIによると、今回テストしたワークロードでは持続的な実測電力は550W以下だったとされています。
数字だけ見ると非常に強い結果ですが、比較条件は固定ではありません。モデル、量子化、入力長、出力長、推論方式、ネットワーク構成などが変われば結果も変わります。今回の数字は「Jalapeñoがあらゆる環境で常に1.5〜3.6倍優れている」という意味ではありません。
なぜAIエージェントでは「低遅延」が特に重要なのか
通常のチャットでは、回答開始まで1秒短くなるだけなら大きな違いに感じないこともあります。しかしAIエージェントでは、その1秒が何十回も積み重なります。
たとえばコーディングエージェントが1つの不具合を直すとき、次のような処理を順番に行うことがあります。
- Issueや依頼文を読む
- リポジトリ内を検索する
- 関連ファイルを読む
- 修正方針を考える
- コードを書く
- テストを実行する
- エラーを読む
- 再修正する
- 差分を確認する
- 最終回答を作る
各ステップでモデル推論が必要になると、単発応答の遅延ではなく、タスク全体の待ち時間が問題になります。
1回の推論が0.5秒短縮されても、100回呼び出せば単純計算では50秒の差になります。実際のエージェントはツール実行やネットワーク待ち時間もあるため単純計算にはなりませんが、推論遅延の積み重ねが重要になる点は変わりません。
OpenAIも公式発表で、エージェントは多数の処理を順番に行うため、遅延がタスク全体で累積すると説明しています。
今後AIエージェントが長時間タスクへ広がるほど、「1回の回答速度」より「一連の仕事を終えるまでの総時間」が重要になります。推論チップの効率化は、その総時間を縮めるためのインフラ側の改善です。
Jalapeñoはなぜスループットと低遅延を両立できるのか
大規模言語モデルの推論は、最初から最後まで同じ種類の処理をしているわけではありません。
大きく分けると、入力されたプロンプトをまとめて処理する「prefill」と、回答を1トークンずつ生成していく「decode」があります。
prefillは計算能力への依存が大きく、decodeはメモリ帯域の影響を受けやすいという違いがあります。さらに複数チップを使う場合は、チップ間でモデル状態やデータを移動する通信時間も発生します。
そのため、ある処理では非常に速いチップでも、別の段階ではメモリ待ちや通信待ちが増え、システム全体では遅くなることがあります。
OpenAIはJalapeñoについて、モデル状態やKVキャッシュを必要な場所へ配置しやすくし、計算、メモリ、ネットワークを各推論段階に合わせて動かせる設計にしたと説明しています。
ここで重要なのは、AIサービスの速度は「GPUやASICの演算性能」だけでは決まらないことです。
SEがWebシステムを高速化するときも、CPUだけ速くして終わりにはしません。データベース、キャッシュ、ネットワーク、I/O、アプリケーションロジックを含めてボトルネックを探します。AI基盤でも同じで、チップだけでなく、メモリと通信を含めた全体設計が効いてきます。
AIを使ってAIチップを設計・最適化している点も重要
今回の発表には、もうひとつ興味深い点があります。OpenAIはJalapeñoの開発そのものにもAIを利用しています。
公式説明では、AIを使って実装候補を探索し、設計、測定、検証の反復を短縮したことで、初期設計からテープアウトまで9カ月で進めたとしています。また算術回路の最適化にもAIを利用したと説明しています。
さらにJalapeñoは、AI自身がプログラム最適化しやすい構造も意識して設計されています。
OpenAIは、GPT-Astraを使ったCodexで、Jalapeñoの当初の本番計画に含まれていなかった3つのオープンウェイトモデルを2カ月以内に高性能で動作させたとしています。
特定のGPT-OSSのattentionブロックとmixture-of-expertsブロックでは、AIが生成した実装が、既存の人間の専門家による実装より1.5〜1.8倍高速だったケースも報告されています。ただし、これは選ばれた一部ブロックの結果であり、モデル全体が1.5〜1.8倍高速になったという意味ではありません。
この話は、SEの開発現場にもつながります。
AIコーディングは、単純なコード生成だけでなく、性能測定、実装候補探索、最適化ループまで入ってきています。将来的には、人間が「正しい実装を書く」ことに加え、AIに複数案を作らせ、ベンチマーク結果で選ぶ設計がさらに増える可能性があります。
ユーザーにとってAPI料金がすぐ安くなるわけではない
Jalapeñoの電力効率が高いと聞くと、「OpenAI APIの料金もすぐ下がるのでは」と期待したくなります。
しかし2026年8月26日時点で、OpenAIはJalapeñoの発表に合わせた具体的なAPI価格改定を発表していません。
推論コストは、チップの電力だけでは決まりません。データセンター設備、ネットワーク、メモリ、サーバー、ソフトウェア開発、人件費、冗長化、運用、モデル開発費など、複数のコストがあります。
また、効率が上がると利用量が増える可能性もあります。AIが安く高速になるほど、今まで採算が合わなかった用途でもAIを使えるようになり、結果的に総計算量が増えることも考えられます。
OpenAI自身も、効率改善によってAIの利用可能な仕事を広げる考え方を示しています。
そのためJalapeñoの意味は、「値下げ確定」ではなく、OpenAIが今後、より多くのユーザーや長時間動くエージェントを支えるために、推論原価と供給能力を改善する手段を持ったことにあります。
SE実務では何を見ればよいか
Jalapeñoそのものを一般のSEが直接購入したり、クラウドから指定して使ったりする話ではありません。少なくとも現時点で、そのような一般提供は公式に案内されていません。
それでも、この発表から学べる点はあります。
1. AI性能はモデル名だけで比較しない
同じモデルでも、推論基盤が違えば応答速度や同時処理能力は変わります。AIサービスを比較するときは、モデルのベンチマークだけでなく、実際のAPIレイテンシ、タイムアウト率、同時実行制限も測った方が実務的です。
2. エージェントでは1回の速度よりタスク完了時間を見る
コーディングエージェントや業務エージェントでは、1回の回答速度より、最終成果物まで何分かかったかを測る方が重要です。モデルが速くても、リトライが多かったりツール呼び出しが失敗したりすれば、総時間は短くなりません。
3. トークン単価とインフラ効率を分けて考える
API料金は利用者側の価格、推論効率は提供者側の計算効率です。両者は関係しますが同じではありません。ニュースを読むときに「効率が2倍=価格が半額」と短絡しないことが大切です。
4. 自社AIでもボトルネックを分解する
AI機能が遅いとき、原因が必ずモデルとは限りません。RAG検索、外部API、データベース、プロンプト生成、ネットワーク、再試行処理、ツール実行待ちが原因のこともあります。
AI基盤を改善するときは、各工程の時間をログに残し、どこで待っているかを分解して測定する方が効果的です。
既存のGPUが不要になるわけではない
OpenAIが自社チップを作ったからといって、NVIDIAなどの外部アクセラレータをやめるわけではありません。
OpenAIは公式発表で、今後もNVIDIAや他のパートナーのアクセラレータを、学習と推論の両方で広く使い続けると説明しています。
これはインフラ設計として自然です。
AIワークロードには、巨大モデルの学習、大量ユーザー向け推論、低遅延エージェント、バッチ処理など異なる用途があります。すべてを1種類のチップへ統一するより、用途に応じて最適な計算資源を使い分ける方が合理的です。
企業システムでも同じ考え方が使えます。
すべての処理を最高性能モデルに任せる必要はありません。難しい推論だけ高性能モデルへ送り、分類や整形は軽量モデルへ回す。リアルタイム処理と夜間バッチを分ける。障害時には別モデルへ切り替える。こうした使い分けは、AIサービス側のハードウェア戦略と似た考え方です。
今回のベンチマークを見るときの注意点
Jalapeñoの結果は興味深い一方で、評価にはいくつか注意が必要です。
まず、公開結果はOpenAIが発表したものです。InferenceX自体は公開ベンチマークですが、実際の製品環境で同じ差が常に再現されるとは限りません。
次に、比較対象はGPT-OSS 120BではGB200、DeepSeek R1とKimi K2.5ではGB300を使った特定構成です。ハードウェアやソフトウェアは継続的に更新されるため、将来の最新世代との比較結果は変わる可能性があります。
また、JalapeñoはまだOpenAIのインフラへ大規模導入済みという段階ではありません。公式には2026年末までに導入を開始する計画で、現在は量産に向けた検証、ソフトウェア成熟、より多くのモデルでの性能確認を進めている段階です。
さらにOpenAI内部のフロンティアモデルで優位性が広がったという説明もありますが、その内部テストの詳細は公開モデルのベンチマークほど確認できません。記事や導入判断では、公開されている範囲と内部評価を分けて考える必要があります。
ベンチマークは「優れている可能性を示す材料」であり、「すべての環境での結果を保証するもの」ではありません。
Jalapeñoから見えるAIサービス競争の変化
これまで生成AIの競争は、「どのモデルが最も賢いか」が中心に見えました。
しかしユーザー数が増え、エージェントが長時間動くようになると、モデル性能だけでは競争できません。
必要になるのは、同じ電力で何件の処理をこなせるか、どれだけ低遅延で返せるか、供給量をどれだけ増やせるか、インフラコストをどこまで抑えられるかです。
OpenAIは8月25日の別の公式発表で、データセンター、チップ、モデル、開発者向けプラットフォーム、消費者・企業向け製品までを一体として最適化する「フルスタック」の考え方を示しています。
この流れが進むと、AIサービスの競争力は次のような要素の掛け算になります。
- モデルの能力
- 推論速度
- 電力効率
- 利用価格
- 安定性と供給能力
- エージェント実行環境
- 開発者向けAPIやツール
SEがAIサービスを選ぶときも、「ベンチマーク1位のモデルを選ぶ」だけでは足りなくなります。実際のシステムで、価格、速度、可用性、制限、開発しやすさまで合わせて評価する必要があります。
まとめ
OpenAIが2026年8月25日に公開したJalapeñoの初回ベンチマークは、生成AIの競争がモデルだけでなく、推論チップとシステム全体の最適化へ広がっていることを示しています。
公開結果では、GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tにおいて、ピーク時の1ワット当たりAI処理量が比較システムの1.5〜1.9倍、エンドツーエンド遅延が1.7〜3.6倍低い結果でした。
特にAIエージェントでは、複数の推論を順番に実行するため、低遅延の価値が大きくなります。単発のチャットでは小さく見える差でも、長いタスクでは積み重なります。
一方で、この結果からAPI値下げやChatGPTの即時高速化を断定することはできません。Jalapeñoは2026年末までにOpenAIの計算基盤への導入を始める計画であり、ベンチマークも特定条件での比較です。
SEとして今回のニュースから持ち帰りたいのは、「AI性能はモデルだけで決まらない」という点です。AIを業務システムへ組み込むときも、モデル性能、API速度、リトライ、RAG、外部ツール、ネットワークまで含めてタスク完了時間と総コストを見ることが、これまで以上に重要になります。
コメント