
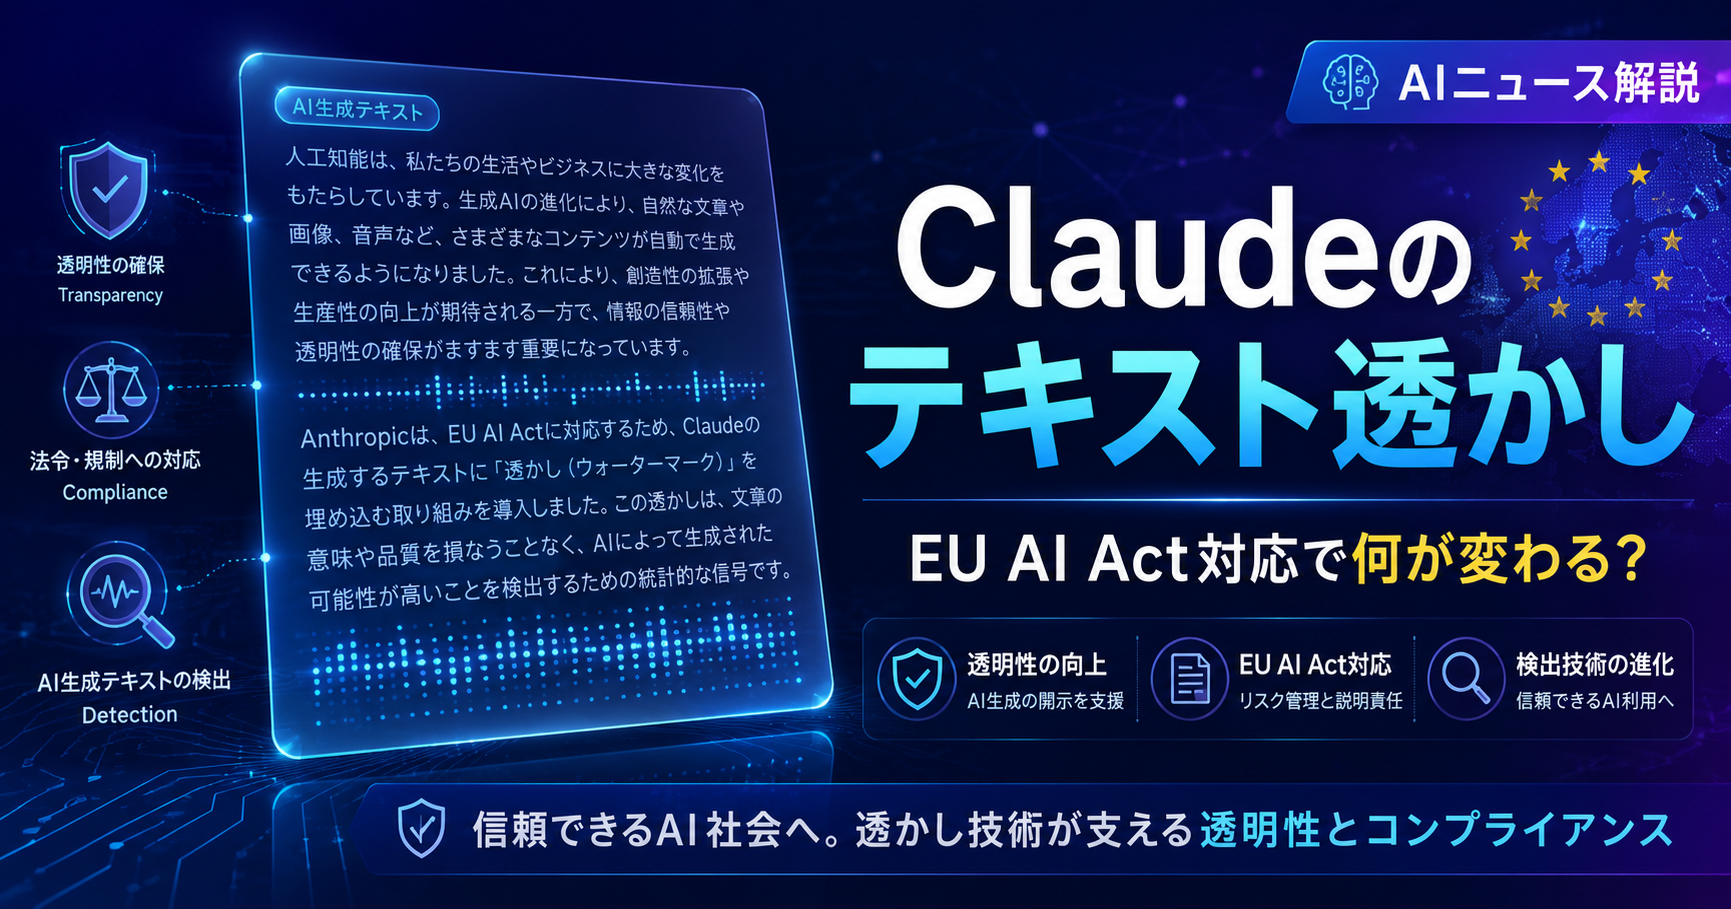
Anthropicは2026年8月14日、将来のClaudeモデルが生成するテキストに「透かし(watermark)」を導入すると発表しました。画面に見える印や特殊な文字を付けるのではなく、文章生成時の単語選択に検出可能なパターンを持たせる仕組みです。
今回の変更は、EU AI Act(EU AI法)の透明性要件への対応が背景にあります。Claudeを仕事で使っているSEやフリーランスにとって重要なのは、「文章の見た目や料金が大きく変わる」という話ではない一方で、AI生成物の扱い方や社内ルール、成果物の説明責任を見直すきっかけになる点です。
2026年8月15日時点でAnthropicが公開している情報を基に、仕組み、実務への影響、検出の限界、コードや翻訳での扱いまで整理します。
先に結論:Claudeの透かしは「見えない生成パターン」で、利用者を特定するものではない
Anthropicの説明を短くまとめると、Claudeのテキスト透かしには次の特徴があります。
- 文章中に見える記号や隠し文字を追加する方式ではない
- 文章生成時の単語選択に、後から検出できる統計的なパターンを持たせる
- 通常の読み手には透かしの有無を区別できない
- 追加トークンを必要とせず、透かしを理由に料金が上がるわけではない
- 利用者名、企業名、チャット内容などの個人識別情報は含まない
- 短文、厳密な事実記述、軽い校正、コードなどでは検出しにくい場合がある
- 将来的にAnthropicは透かし検出APIを提供する予定としている
つまり、「Claudeで書いた文章にユーザーIDが埋め込まれる」という話ではありません。どのユーザーが生成したかを追跡する仕組みではなく、ある文章についてClaudeが生成や大幅な編集に関与した可能性を判定しやすくするための技術です。
一方で、透かしは万能なAI判定技術ではありません。Anthropic自身も、短い文章では判定材料が少なく、全面的に書き換えれば透かしが消える可能性があると説明しています。この限界を理解せず、「透かし検出=AI利用の完全な証明」と考えるのは危険です。
なぜAnthropicは今、Claudeにテキスト透かしを導入するのか
背景にあるのは、EU AI Actの透明性要件です。欧州委員会によると、AI Act第50条の透明性義務は2026年8月2日から適用されています。生成AIの提供者には、AIが生成または操作したコンテンツを機械的に検出できるようにするためのマークを付与することなどが求められます。
Anthropicは、EUのAI生成コンテンツ透明性に関するCode of Practice(実務規範)へ署名しており、その対応としてClaudeの出力へ透かしを導入すると説明しています。Anthropicによると、開始時点では地域ごとに確実に切り分ける方法がないため、透かしはグローバルに適用する方針です。
ここで注意したいのは、「EUでClaudeを使う人だけの話」ではない点です。Anthropicがグローバル適用を明示している以上、日本からClaudeを利用する場合でも、将来モデルの生成テキストに同じ仕組みが適用される可能性があります。
ただし、すべての旧モデルへ一斉に同じタイミングで適用されるわけではありません。Anthropicは、2026年8月2日より前に公開されたモデルについては移行期間があり、今後数か月かけて対応するとしています。利用しているモデルや提供形態によって適用時期が異なる可能性があるため、業務利用ではモデル更新情報も確認しておくのが現実的です。
Claudeのテキスト透かしはどうやって埋め込まれるのか
一般的な「透かし」と聞くと、画像に半透明のロゴを重ねたり、文書に識別番号を埋め込んだりする方法を想像しがちです。Claudeのテキスト透かしはそれとは違います。
大規模言語モデルは、直前までの文脈を基に次の単語やトークン候補を評価し、その中から続きを選びながら文章を生成します。意味としてどちらを選んでも問題がない候補が複数ある場面では、選択に一定のランダム性があります。
Anthropicが採用する方式は、Google DeepMindが発表したSynthID-Textを基にしたものです。意味や品質を変えない範囲の選択に対し、鍵と直前の単語列を使って特定のパターンが生じるようにします。後からその鍵を使って文章全体の単語選択を調べることで、「Claudeの透かしと整合するパターンがどの程度含まれているか」を判定できます。
重要なのは、透かしを入れるために余分な文字列を挿入しているわけではないことです。HTMLのコメント、ゼロ幅文字、見えないUnicode文字のようなものを文章の裏側へ追加する方式ではありません。そのため、テキストをコピーしただけで透かし部分が見つかる、という性質ではありません。
品質・速度・料金への影響はどうなる?
Anthropicは、社内テストではテキストの内容、創造性、読みやすさへの影響は確認されていないと説明しています。また、基盤となるSynthID-Textについても、Google DeepMindの実運用テストで、透かしあり・なしの出力に対する利用者評価で統計的に有意な差が確認されなかったとしています。
料金についても、透かし処理のために追加トークンを生成するわけではないため、透かしを理由に利用料金が上がるものではありません。速度への影響も「negligible(無視できる程度)」とされています。
SEの実務で考えると、今回の変更を理由にプロンプト設計や既存のClaude利用フローを大きく変える必要は現時点ではなさそうです。仕様上は、通常の要件整理、文章作成、コードレビュー、議事録の要約などで、出力品質が意図的に落とされる変更ではありません。
ただし、社内規程で「AI生成コンテンツをどのように扱うか」が定められている企業では話が別です。将来的に機械判定の仕組みが一般化すると、AIを利用した成果物であることをどの段階で申告するか、最終成果物を人がどこまで確認するか、といった運用ルールの方が重要になります。
短文・校正・コードでは透かしを検出しにくい
Claudeの透かしには、技術的な限界があります。これは業務利用で誤解しやすいポイントです。
短い文章
透かしは、多数の単語選択を観察して統計的なパターンを確認する仕組みです。文章が短いほど観測できる選択回数が少ないため、判定の確度は下がります。数行の回答や短いメールだけを見て、確実にClaude由来だと判定できるとは限りません。
事実中心の文章
固有名詞、数値、公式名称、決まった用語など、正解がほぼ一つに決まる部分では、透かしを入れるための選択肢がほとんどありません。Anthropicも、事実中心の文章では透かしが疎になると説明しています。
人が書いた文章の軽い校正
人間が書いた文章をClaudeへ渡し、「誤字脱字と句読点だけ直して」と依頼した場合、Claudeが新たに選ぶ単語は少なくなります。そのため、透かしを検出できるほどの変更が入らない可能性があります。
プログラムコード
コードでは、変数名やコメントなど自由度のある部分を除き、文法やAPI仕様に従って正確な記述をする必要があります。任意の単語選択を行える場面が文章より少ないため、一般文章と比べて透かしが入りにくいとAnthropicは説明しています。
したがって、コードを検出APIにかけて反応しなかったからといって、「Claudeは使われていない」と断定することはできません。逆に、透かしが検出された場合も、それだけでClaudeが文章全体を一から作成したと証明するわけではありません。
翻訳には透かしが入る一方、利用者情報は埋め込まれない
Anthropicによると、Claudeが生成した翻訳文には透かしが適用されます。翻訳では出力文のほぼすべての単語をClaudeが選択するため、軽い校正よりも透かしを持たせやすいためです。
一方で、透かしにはユーザーを識別する情報は含まれません。個人名、所属企業、アカウント、チャットIDなどを透かしから復元できる仕組みではないとAnthropicは明示しています。
企業利用ではこの点を切り分けて考える必要があります。「Claudeが関与した可能性を検出する」ことと、「誰がいつどのチャットで生成したかを追跡する」ことは別です。監査証跡が必要な業務では、透かし任せにせず、既存のアクセスログ、成果物管理、レビュー記録などを組み合わせる必要があります。
画像やファイルはテキスト透かしではなくC2PAで扱う
Claudeが生成する画像や一部のファイルについては、テキストと同じ方式ではなく、C2PAという業界標準のContent Credentialsが使われます。
Anthropicの説明では、対応するPNG、JPEG、SVGなどのファイルへ、Claudeが作成または処理したことを示す暗号学的に署名された情報をメタデータとして付与します。こちらも利用者の個人情報を記録するものではありません。
テキストの透かしは「生成時の単語選択パターン」、ファイルでは「メタデータ上のContent Credentials」と、技術が異なります。業務で生成AI成果物を管理する場合は、すべてを一括して「透かし」と考えず、媒体ごとに確認方法が違うことを把握しておくと混乱を避けられます。
SE・フリーランスが実務で確認しておきたい5つのポイント
1. AI利用申告の社内ルールを確認する
透かし技術の普及によって、AI利用の有無が後から検証される場面は増える可能性があります。顧客や所属組織にAI利用方針がある場合は、まずその規程を優先してください。「検出されなければ問題ない」という運用は避けるべきです。
2. AI判定結果だけで人を評価しない
Anthropic自身が、短文や校正、コードなどでは検出精度に限界があると説明しています。検出結果だけで「AIを使った」「使っていない」を断定し、人事評価や契約判断へ直結させるのは危険です。
3. 納品物は人が内容を確認する
透かしは内容の正しさを保証しません。Claudeが関与したことを推定できても、要件に合っているか、数値が正しいか、機密情報が含まれていないかは別問題です。設計書、調査結果、顧客向け資料などは従来通り人によるレビューが必要です。
4. 機密情報の入力ルールは別途守る
透かしに個人識別情報が入らないことと、入力データの取り扱いが安全であることは同義ではありません。業務データをClaudeへ入力する場合は、契約プラン、データ利用条件、社内規程、顧客との秘密保持契約を確認してください。
5. 検出APIの提供開始後に運用を再点検する
Anthropicは、透かしを確認するための検出APIを今後提供する予定としています。2026年8月15日時点では、記事中で具体的な一般提供日や料金までは確認できません。提供開始後は、APIの対象モデル、利用条件、判定結果の意味、保存すべきログを確認してから業務へ組み込むのが安全です。
メリットとデメリットをどう見るべきか
利用者側のメリットは、AI生成コンテンツの透明性を高める仕組みが、目に見えるラベルだけでなく機械的な検出手段として整備されることです。文章の読みやすさや料金を大きく変えずに導入できれば、通常利用への負担は比較的小さく抑えられます。
一方、デメリットというより注意点として、透かしを過信しないことが挙げられます。短文では検出しにくく、文章を大きく書き換えれば透かしが失われる可能性があります。また、Claudeの透かしを検出できても、他社AIによる文章かどうかまで判断できるわけではありません。
そのため、透かしは「AI生成物を完全に見分ける万能判定機」ではなく、透明性を高めるための一つの技術的手段として扱うのが適切です。
今から対応するなら、まず運用ルールの確認から
一般ユーザーが今すぐ設定を変更したり、特別なツールを導入したりする必要はありません。優先したいのは、自分や組織がAI生成物をどう扱うかを整理することです。
特にSEやフリーランスは、顧客向け成果物、設計書、調査資料、コード、翻訳文などでAIを利用する機会があります。これらは媒体によって透かしの効き方が異なり、検出結果だけでは利用状況を完全に説明できません。
まずは、AI利用申告のルール、成果物レビューの責任範囲、機密情報の入力基準を確認する。そのうえで、Anthropicの検出APIが公開された段階で必要なら技術的な確認手順を追加する。この順番が現実的です。
まとめ
Anthropicが導入するClaudeのテキスト透かしは、文章に見える印や隠し文字を追加するものではなく、生成時の単語選択へ検出可能なパターンを持たせる方式です。基盤技術にはGoogle DeepMindのSynthID-Textが使われます。
Anthropicは、品質、創造性、読みやすさへの実用上の影響はなく、追加トークンも発生しないと説明しています。利用者や組織を識別する情報も透かしには含まれません。
ただし、短文、軽い校正、厳密な事実記述、コードなどでは検出しにくく、透かしだけでAI利用の有無を完全に断定することはできません。業務では、透かしを監査や品質保証の代替手段と考えず、人によるレビューと既存のAI利用ルールを組み合わせることが重要です。
2026年8月15日時点では、Anthropicは透かし検出APIを今後提供するとしています。具体的な提供条件が公開されたら、APIの判定精度や実務での使い方も改めて確認したいところです。
参考情報
- Anthropic:How Claude’s text watermark works(2026年8月14日)
- European Commission:Code of Practice on Transparency of AI-generated Content
- European Commission:Guidelines on transparency obligations for providers and deployers of certain AI systems
- Nature:Scalable watermarking for identifying large language model outputs
コメント